

루프 엔지니어링 실전: Claude Code /goal 분석과 Stop 훅 재구현
안녕하세요. 인포그랩 AI DevOps 엔지니어 Harvey입니다. LLM에 도구와 실행 환경을 연동한 코딩 에이전트로 업무를 자동화하는 건 이제 낯설지 않습니다. 요즘은 Claude Code나 Codex에 이슈 하나를 처음부터 끝까지 맡기기도 하고, CI 파이프라인이나 스케줄러에서 AI 에이전트를 주기적으로 호출하기도 하죠.
그런데 이런 자동화를 조금만 돌려 보면 다음과 같은 어려움에 부딪히곤 합니다. 에이전트가 '작업을 완료했다'며 멈췄지만, 확인해 보면 테스트가 여전히 실패할 때가 있습니다. 작업이 정말 끝났는지는 사람이 매번 직접 확인하고, 덜 됐으면 다시 지시해야 합니다. 이름은 자동화지만, 사람이 여전히 루프의 한가운데서 프롬프트를 입력하고 결과를 직접 확인하고 있죠. 이유는 단순합니다. 보통 에이전트의 턴(이 글에서는 프롬프트 하나를 받아 응답을 마치기까지 작업 단위)은 실제 작업 완료 여부와 관계없이 에이전트가 스스로 '끝났다'고 판단하는 순간 끝나기 때문입니다. 그 판단이 맞는지 에이전트 밖에서 확인하는 단계도, 틀렸을 때 사람 없이 다음 턴을 이어 가게 하는 장치도 에이전트의 기본 동작에는 없습니다.
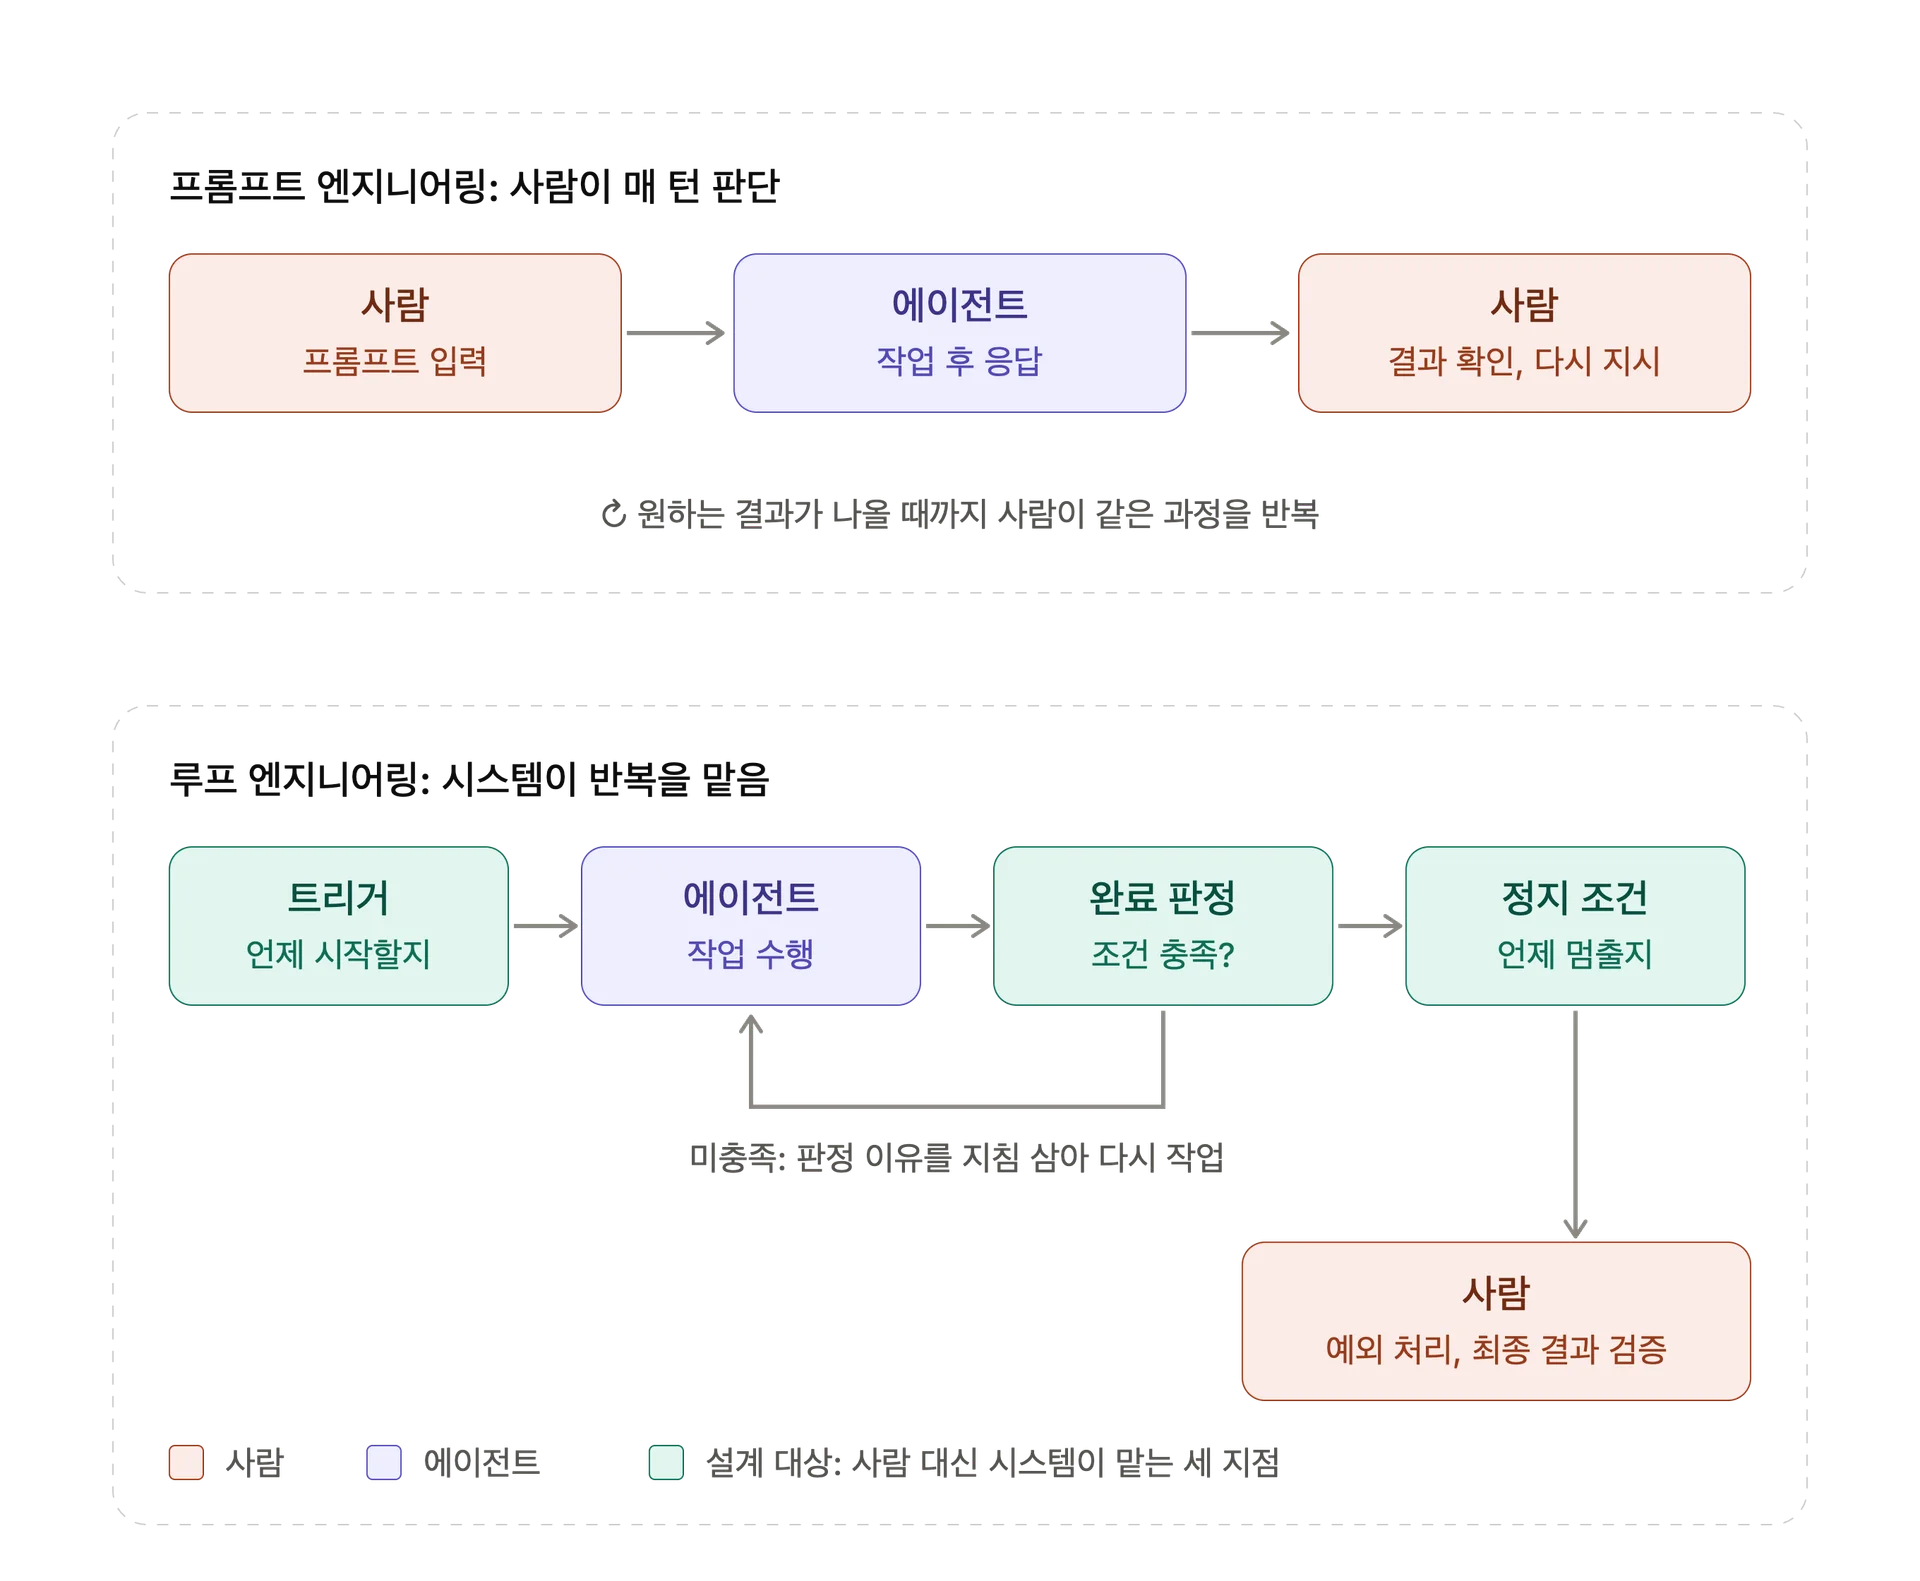
그렇다면 작업이 끝났는지를 에이전트의 자체 판단이 아니라 테스트 통과처럼 확인 가능한 기준으로 판정하고, 기준에 못 미치면 사람 없이 에이전트가 작업을 이어 가게 할 수는 없을까요? 이 질문에 답하는 개념이 최근 주목받는 '루프 엔지니어링'입니다. 이는 언제 작업을 시작할지(트리거), 작업이 끝났다는 걸 무엇으로 판정할지(완료 판정), 언제 작업을 멈출지(정지 조건)를 사람 대신 시스템이 맡도록 설계하는 일입니다.
완료 판정과 정지 조건을 명령어 하나로 제공하는 대표적인 예가 있습니다. 바로 Claude Code의 /goal입니다. 이 명령어를 실행하면 매 턴이 끝날 때마다 별도의 소형 모델이 지금까지 대화 내용을 바탕으로 작업 완료 조건 충족 여부를 판정하고, 아직 충족하지 못했으면 판정 이유를 다음 턴의 지침으로 전달해 사람이 다시 지시하지 않아도 에이전트가 작업을 이어 가게 합니다. 이 글에서는 루프 엔지니어링의 개념과 루프의 유형을 살펴보고, /goal을 분석한 뒤 직접 재구현까지 진행해 보겠습니다.
루프 엔지니어링이란?
IBM의 정의를 빌리면, 루프 엔지니어링은 사람의 개입을 최소화하면서 사용자가 정한 목표를 에이전트가 완수할 때까지 스스로 작업을 반복하도록 루프를 설계하는 일입니다. 이 글에서는 설계 대상을 작업 시작 시점(트리거), 완료 여부를 판정할 기준(완료 판정), 작업 중단 시점(정지 조건) 세 가지로 봅니다. 이 용어는 2026년 6월, 당시 Google Cloud AI 디렉터였던 Addy Osmani(현재 Anthropic에서 Claude Code 개발에 참여)가 에세이 'Loop Engineering'에서 개념으로 정리하며 널리 쓰이기 시작했습니다. 그는 "루프 엔지니어링은 에이전트에 프롬프트를 입력하는 사람인 당신 자신을 대체하는 일이다. 대신 그 일을 하는 시스템을 당신이 설계한다"라고 정의했습니다.
그동안 우리가 LLM을 사용하던 방식은 주로 '프롬프트 엔지니어링'이었습니다. 원하는 결과물이 나올 때까지 사용자가 직접 응답을 확인하고 다시 요구 사항을 작성하는 방식이죠. 일회성 작업은 이 방법으로 충분합니다. 그러나 여러 단계를 거쳐야 하거나 같은 작업을 주기적으로 반복해야 한다면, 사람이 매번 프롬프트를 입력하고 결과를 평가하는 일은 비효율적이고 번거롭습니다. 루프 엔지니어링은 이 문제를 개선합니다. 시스템이 판단해 에이전트가 작업을 반복하게 하고, 사람은 예외 처리와 결과 검증에 집중하는 방식으로 작업 효율을 높이죠. IBM 역시 일회성 상호작용에는 프롬프트 엔지니어링이, 자율 코드 생성이나 소프트웨어 유지보수처럼 여러 단계를 거쳐 오래 실행되는 작업에는 루프 엔지니어링이 맞다고 설명합니다.
루프 엔지니어링이 완전히 새로운 개념은 아닙니다. Osmani의 표현을 빌리면, 1년 전만 해도 루프를 만들려면 개발자가 bash 스크립트를 직접 짜서 관리해야 했지만, 지금은 루프를 이루는 구성 요소(스케줄 실행, 워크트리, 스킬, 플러그인·커넥터, 서브에이전트)가 Codex와 Claude Code 같은 제품에 기능으로 지원됩니다. 이미 존재하던 엔지니어링 방식이 이제 개념으로 정리되고, 제품 기능으로 탑재돼 사용하기 쉬워진 셈입니다.
루프의 유형
이제 루프의 유형을 살펴보겠습니다. 루프를 분류하는 방식은 자료마다 다르지만, 이 글은 Claude Code의 /goal을 다루기에 Claude Code 팀이 제시한 분류를 따릅니다. Claude Code 팀에 따르면, 루프는 "정지 조건이 충족될 때까지 에이전트가 작업 사이클을 반복하는 것"이며, 트리거, 정지 조건, 사용하는 Claude Code 기능, 적합한 작업 유형에 따라 크게 턴형 루프(Turn-based loop), 목표형 루프(Goal-based loop), 시간형 루프(Time-based loop), 주도적 루프(Proactive loop) 네 가지로 분류할 수 있습니다.
턴형 루프
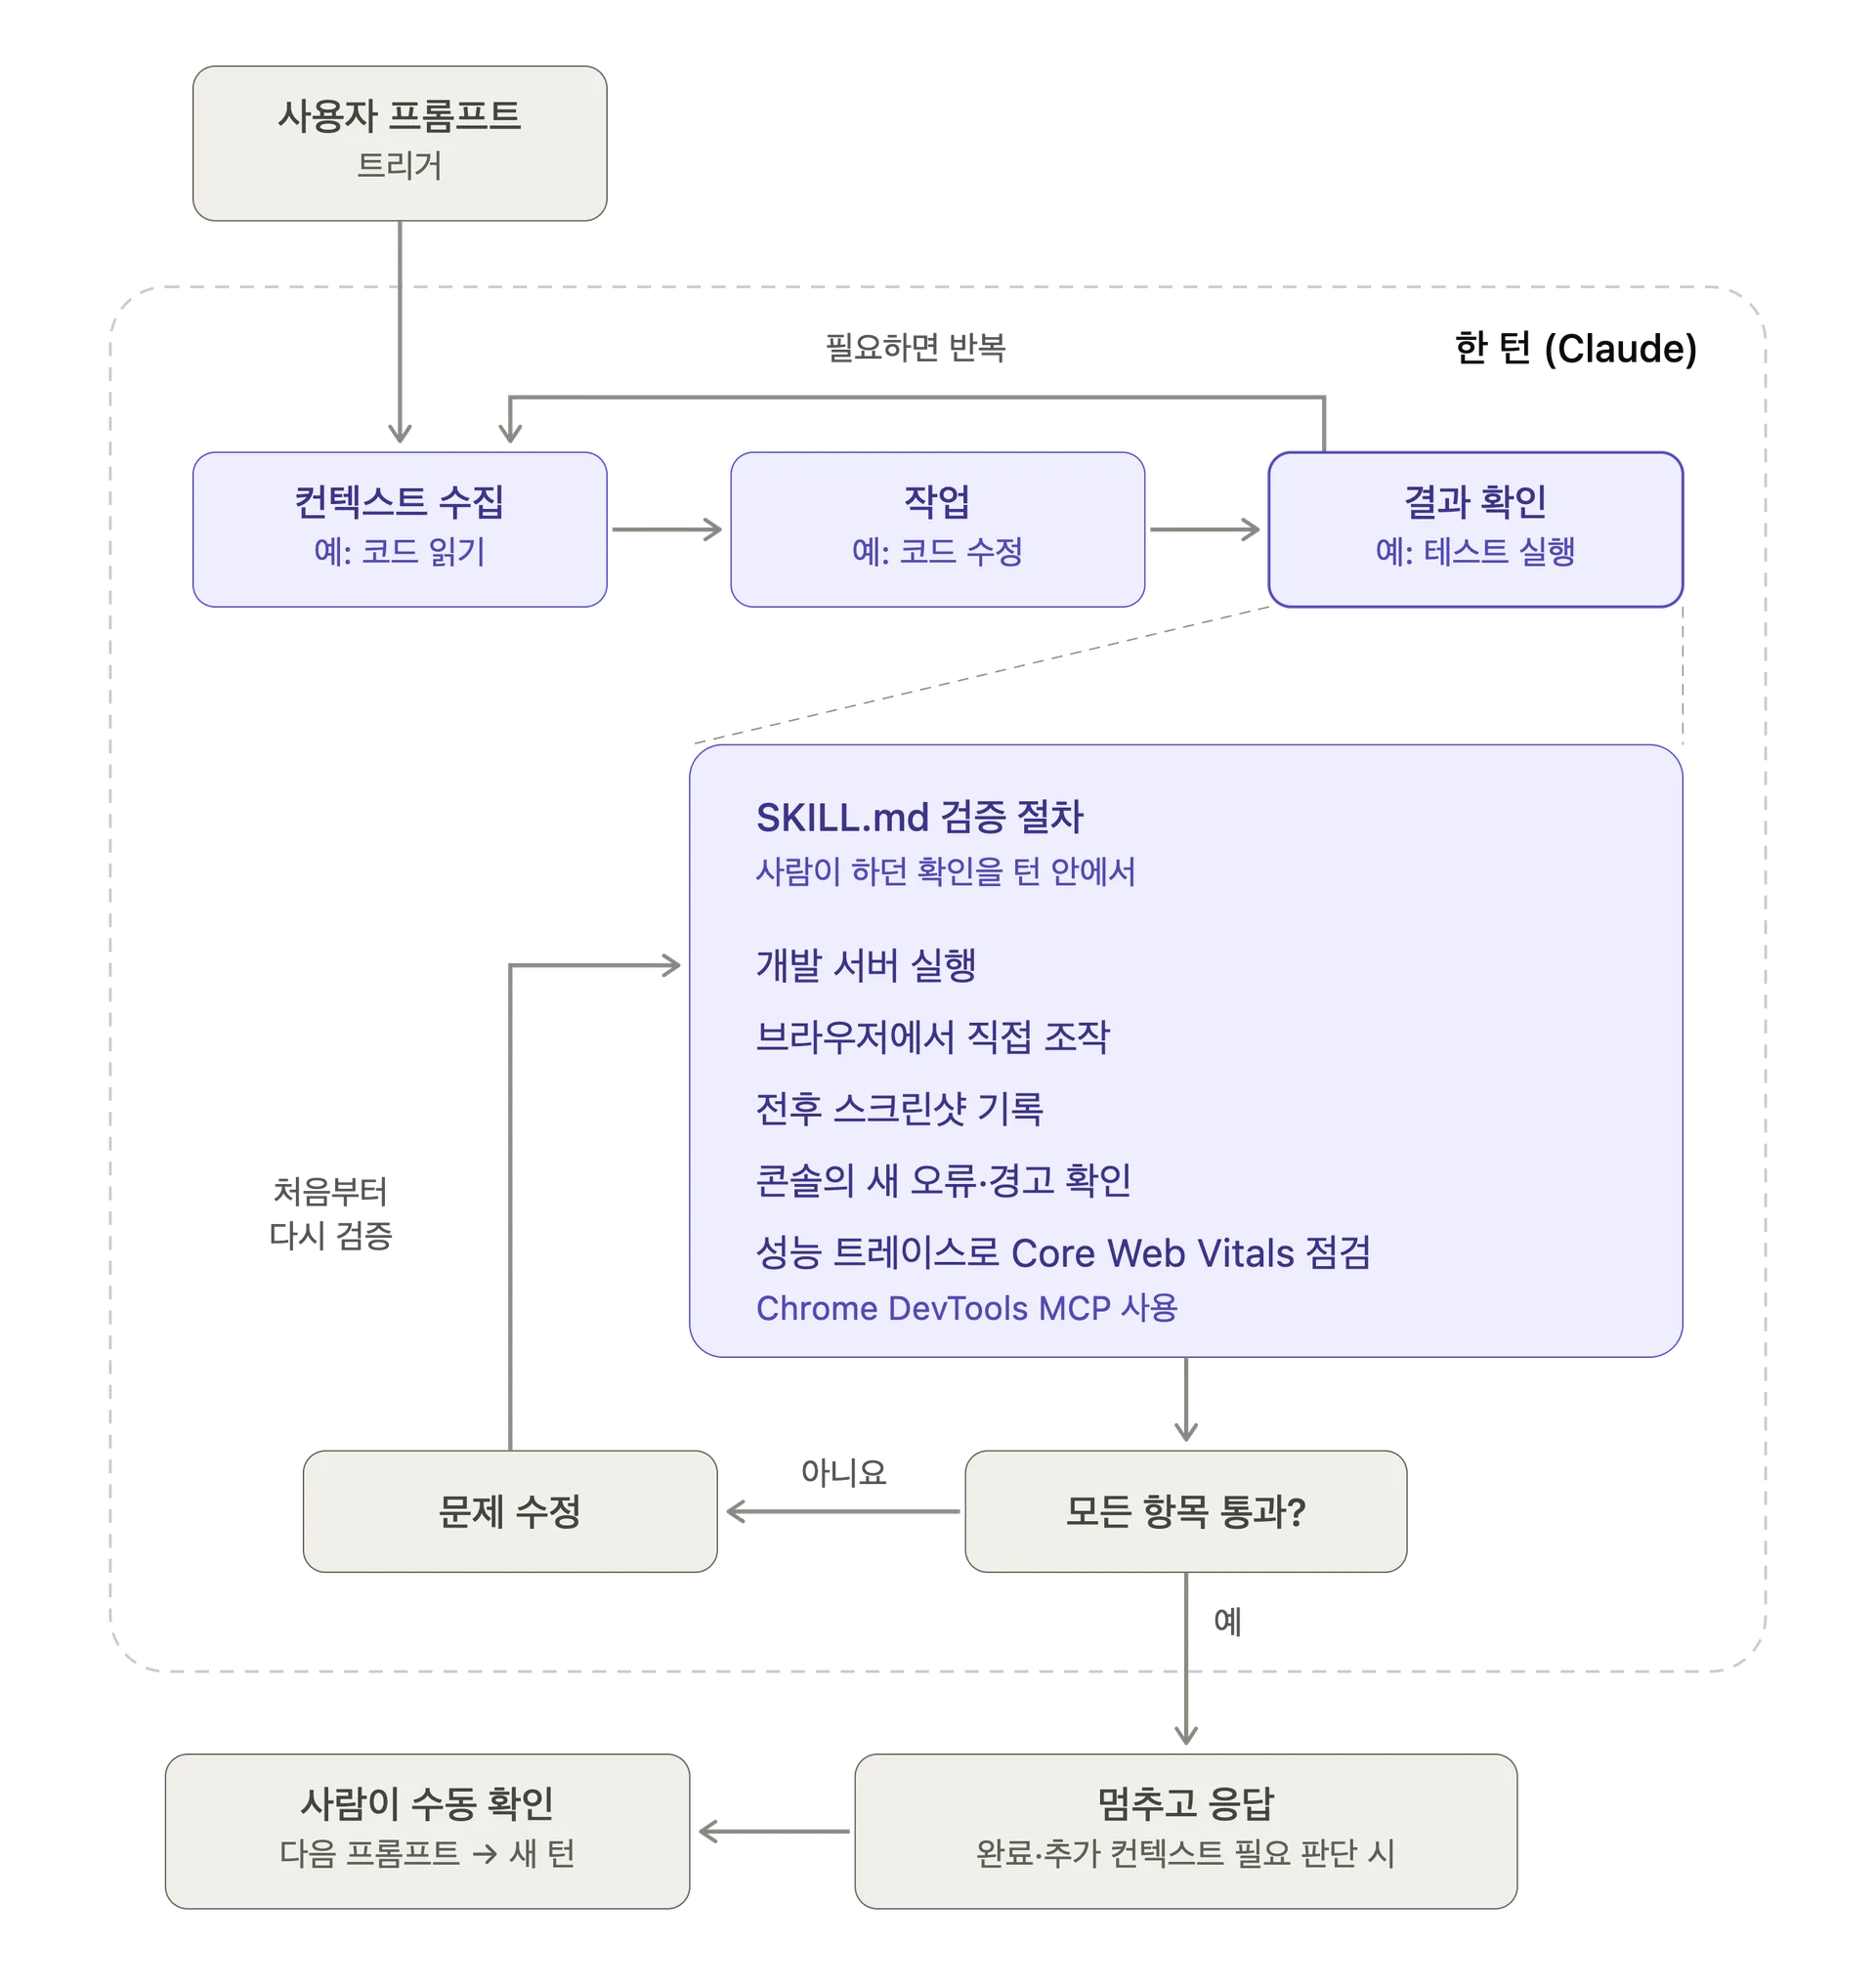
턴형 루프는 사용자 프롬프트 하나로 시작해 Claude가 한 턴 안에서 컨텍스트를 모으고, 작업하고, 결과를 확인하며, 필요하면 이를 반복한 뒤 응답하는 루프입니다. 트리거는 사용자 프롬프트이고, Claude가 작업을 완료했다고 판단하거나 추가 컨텍스트가 필요하다고 판단하면 작업을 멈춥니다. 정기적인 프로세스나 일정에 속하지 않는 비교적 짧은 작업에 적합합니다.
Claude에 ‘좋아요’ 버튼을 구현하도록 요청하는 경우를 예로 살펴보겠습니다. 이때 Claude는 코드를 읽고 수정하고 테스트를 돌린 뒤, 동작한다고 스스로 판단한 결과물을 돌려줍니다. 사람은 그 결과를 수동으로 확인하고 다음 프롬프트를 입력하죠. 이때 사람이 하던 검증 절차를 SKILL.md에 적어 두면 Claude가 턴 안에서 자기 작업의 더 많은 부분을 E2E로 스스로 검사하게 만들 수 있습니다. 이 스킬에는 Claude가 결과를 보거나 측정하거나 직접 조작할 수 있게 해 주는 도구나 커넥터가 포함돼야 합니다.
Claude Code 팀에서는 UI 변경을 편집 성공만으로 완료 처리하지 말고, 개발 서버를 띄워 브라우저에서 직접 조작하고, 전후 스크린샷을 남기고, 콘솔에 새 오류나 경고가 없는지 확인하고, Chrome DevTools MCP로 성능 트레이스를 돌려 Core Web Vitals를 점검한 뒤, 하나라도 실패하면 문제를 고치고 처음부터 다시 검증하라는 예시를 듭니다. 검사 항목이 정량적일수록 Claude가 스스로 검증하기 쉬워지고, 사람이 확인하고 다시 지시하는 횟수도 줄어듭니다.
목표형 루프(/goal)
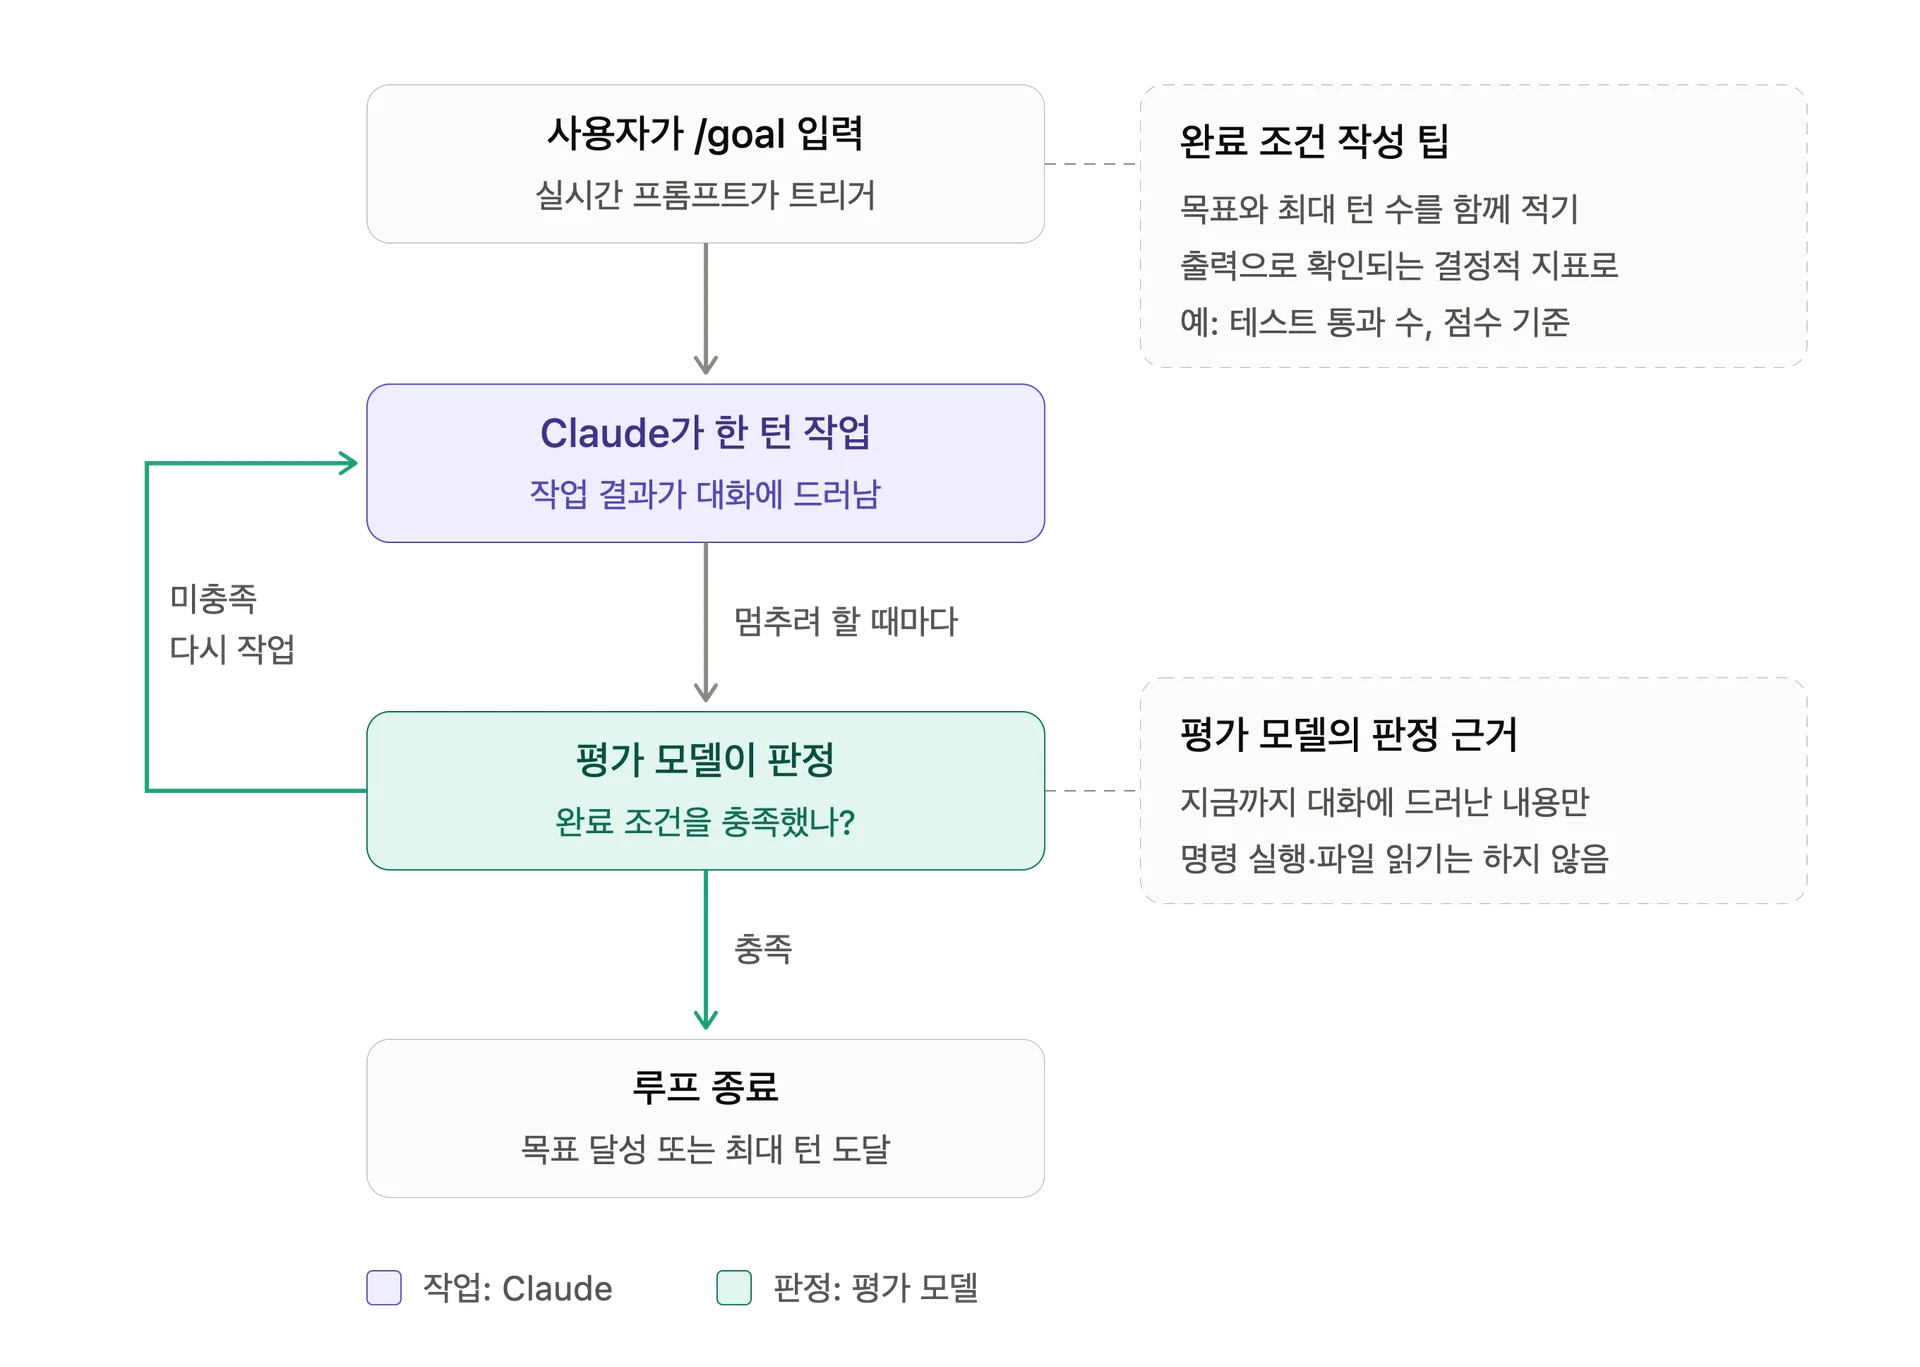
목표형 루프는 사용자가 완료 조건을 정해 두면 Claude가 그 조건을 충족할 때까지 턴을 이어 가는 루프입니다. 트리거는 사용자가 실시간으로 직접 입력하는 프롬프트이고, 목표를 달성하거나 완료 조건에 함께 적어 둔 최대 턴 수에 도달하면 멈춥니다. 테스트 통과처럼 검증 가능한 종료 기준이 있는 작업에 적합합니다.
복잡한 작업은 한 턴으로 충분하지 않을 때가 있고, 에이전트는 반복할 수 있을 때 작업을 더 잘 수행합니다. 완료 조건을 정의해 두면 Claude가 '이 정도면 됐다'고 스스로 판단해 작업이 끝나기 전에 루프를 멈추는 일을 막을 수 있습니다. Claude가 멈추려 할 때마다 평가 모델이 조건 충족 여부를 확인하고, 미충족 상태면 다시 작업하게 하기 때문입니다. 단, 평가 모델은 명령을 실행하거나 파일을 읽지 않고 지금까지 대화에 드러난 내용만 보고 판정하기에 테스트 통과 수나 점수 기준처럼 Claude의 출력으로 확인할 수 있는 결정적인 지표를 성공 기준으로 두는 것이 효과적입니다.
Claude Code에서는 완료 조건을 정해 두면 충족될 때까지 턴을 이어 가는 /goal 명령어로 이 루프를 사용할 수 있습니다. Claude Code 팀은 다음 예시 프롬프트를 제시합니다.
/goal get the homepage Lighthouse score to 90 or above, stop after 5 tries.

(홈페이지 Lighthouse 점수를 90 이상으로 올리되, 5번 시도 후 멈출 것)
시간형 루프(/loop, /schedule)
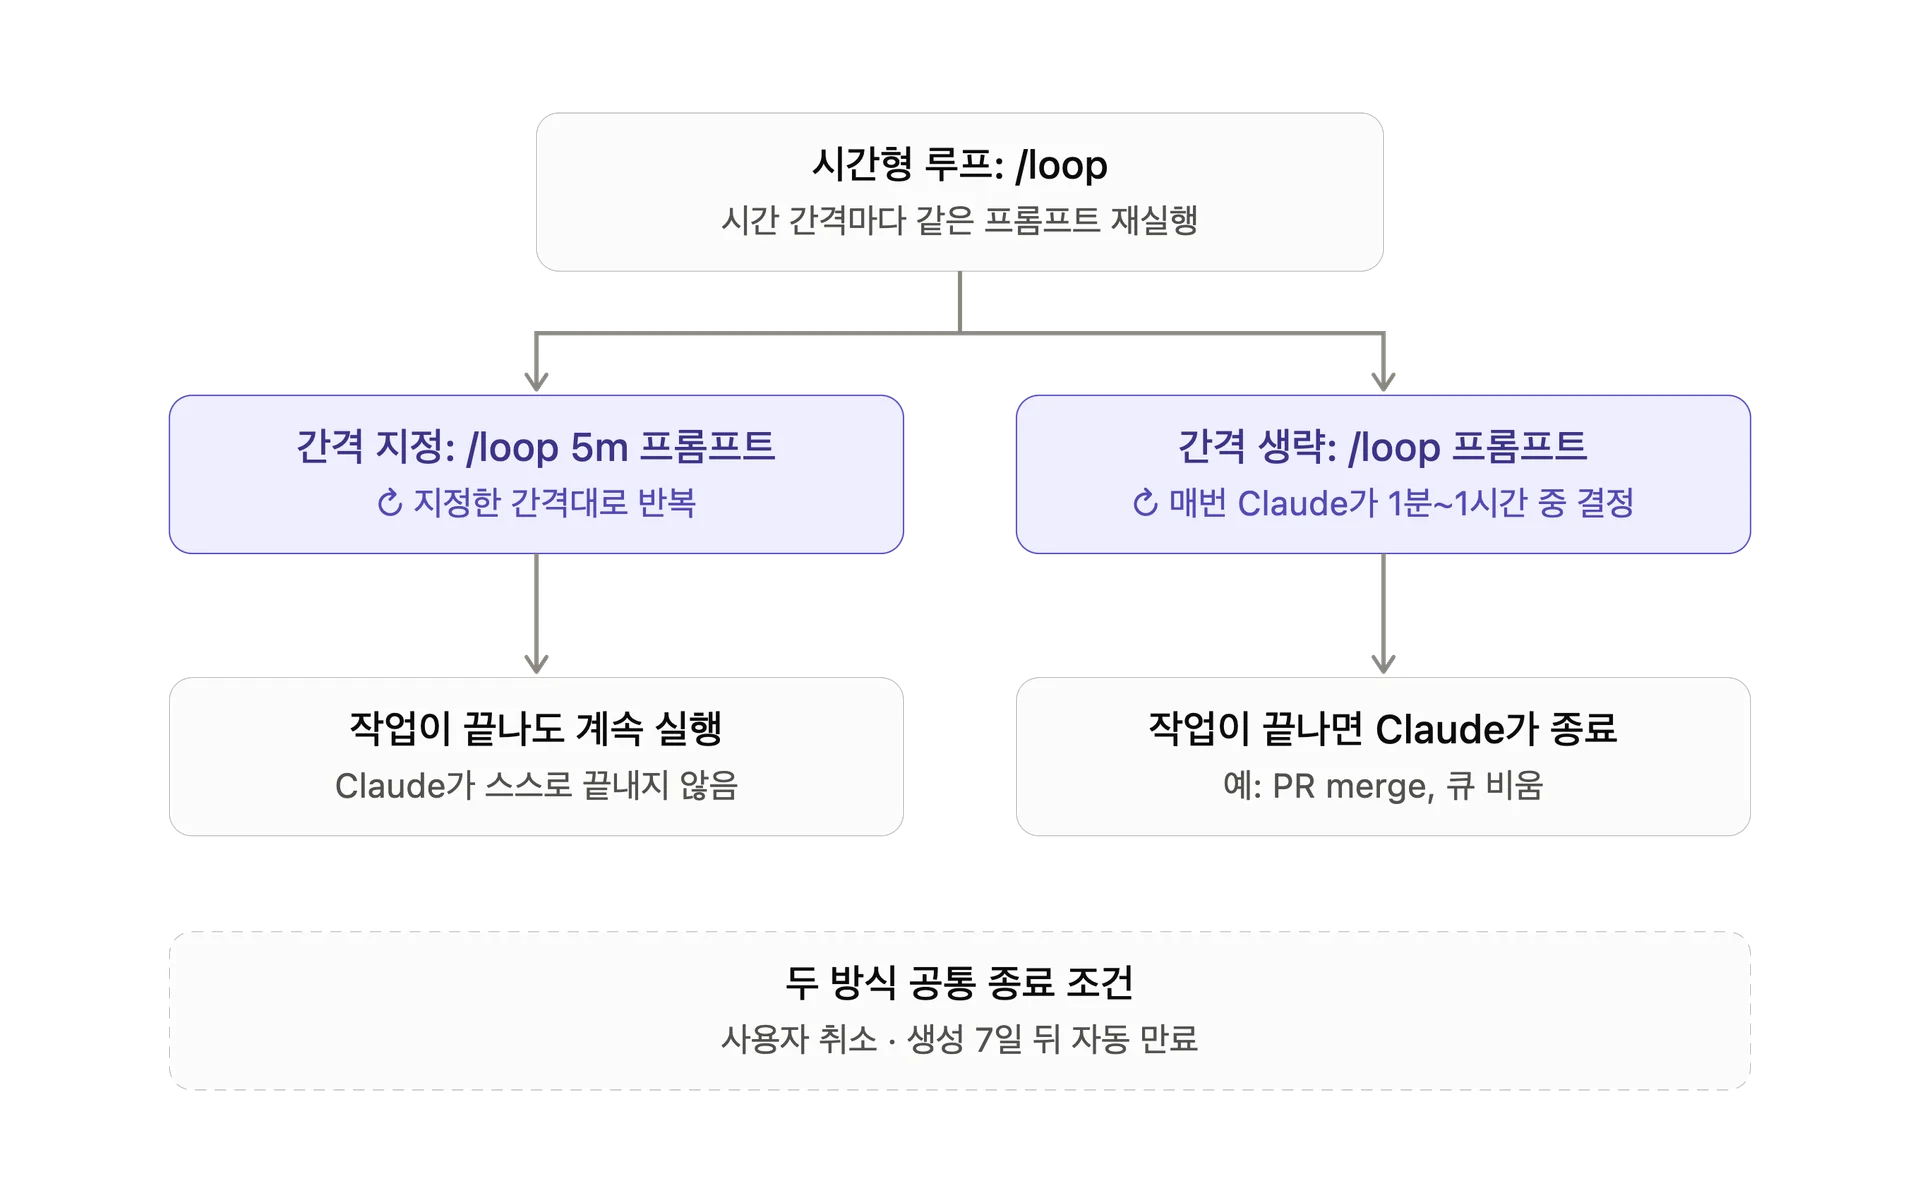
시간형 루프는 시간 간격을 두고 같은 프롬프트를 다시 실행하는 루프입니다. 트리거는 시간 간격이고, 사용자가 실행을 취소하거나 작업이 끝나면(PR이 merge되거나 큐가 비면) 루프가 멈춥니다. 아침마다 Slack 메시지를 요약하는 것처럼 입력만 바뀌고 흐름은 같은 반복 작업, 리뷰가 달리거나 CI가 실패하는 PR처럼 외부 시스템을 주기적으로 확인해 변화에 반응하는 작업에 적합합니다.
Claude Code에서는 /loop로 시간 간격을 두고 프롬프트를 다시 실행할 수 있습니다. 간격을 지정하면 그 간격대로 실행되고, 생략하면 Claude가 매 반복 뒤 1분에서 1시간 사이로 다음 간격을 정합니다. 다만 Claude Code 공식 문서에 따르면 작업이 끝났을 때 Claude가 루프를 스스로 끝낼 수 있는 건 간격을 생략한 경우이고, 아래 예시처럼 간격을 지정한 루프는 사용자가 취소하거나 7일이 지나 자동 만료될 때까지 계속 실행됩니다.
/loop는 내 컴퓨터의 Claude Code 세션 안에서 실행되기에 컴퓨터를 끄거나 세션이 종료되면 멈추고, /schedule로 루틴을 만들면 이 루프를 클라우드에서 실행할 수 있습니다. 루틴은 아직 리서치 프리뷰이고 최소 실행 간격이 1시간이라, 5분 간격 같은 짧은 주기는 클라우드 루틴으로 돌릴 수 없습니다. Claude Code 팀이 든 예시 프롬프트는 다음과 같습니다.
/loop 5m check my PR, address review comments, and fix failing CI

(5분마다 내 PR을 확인해 리뷰 코멘트를 반영하고 실패한 CI를 고칠 것)
주도적 루프
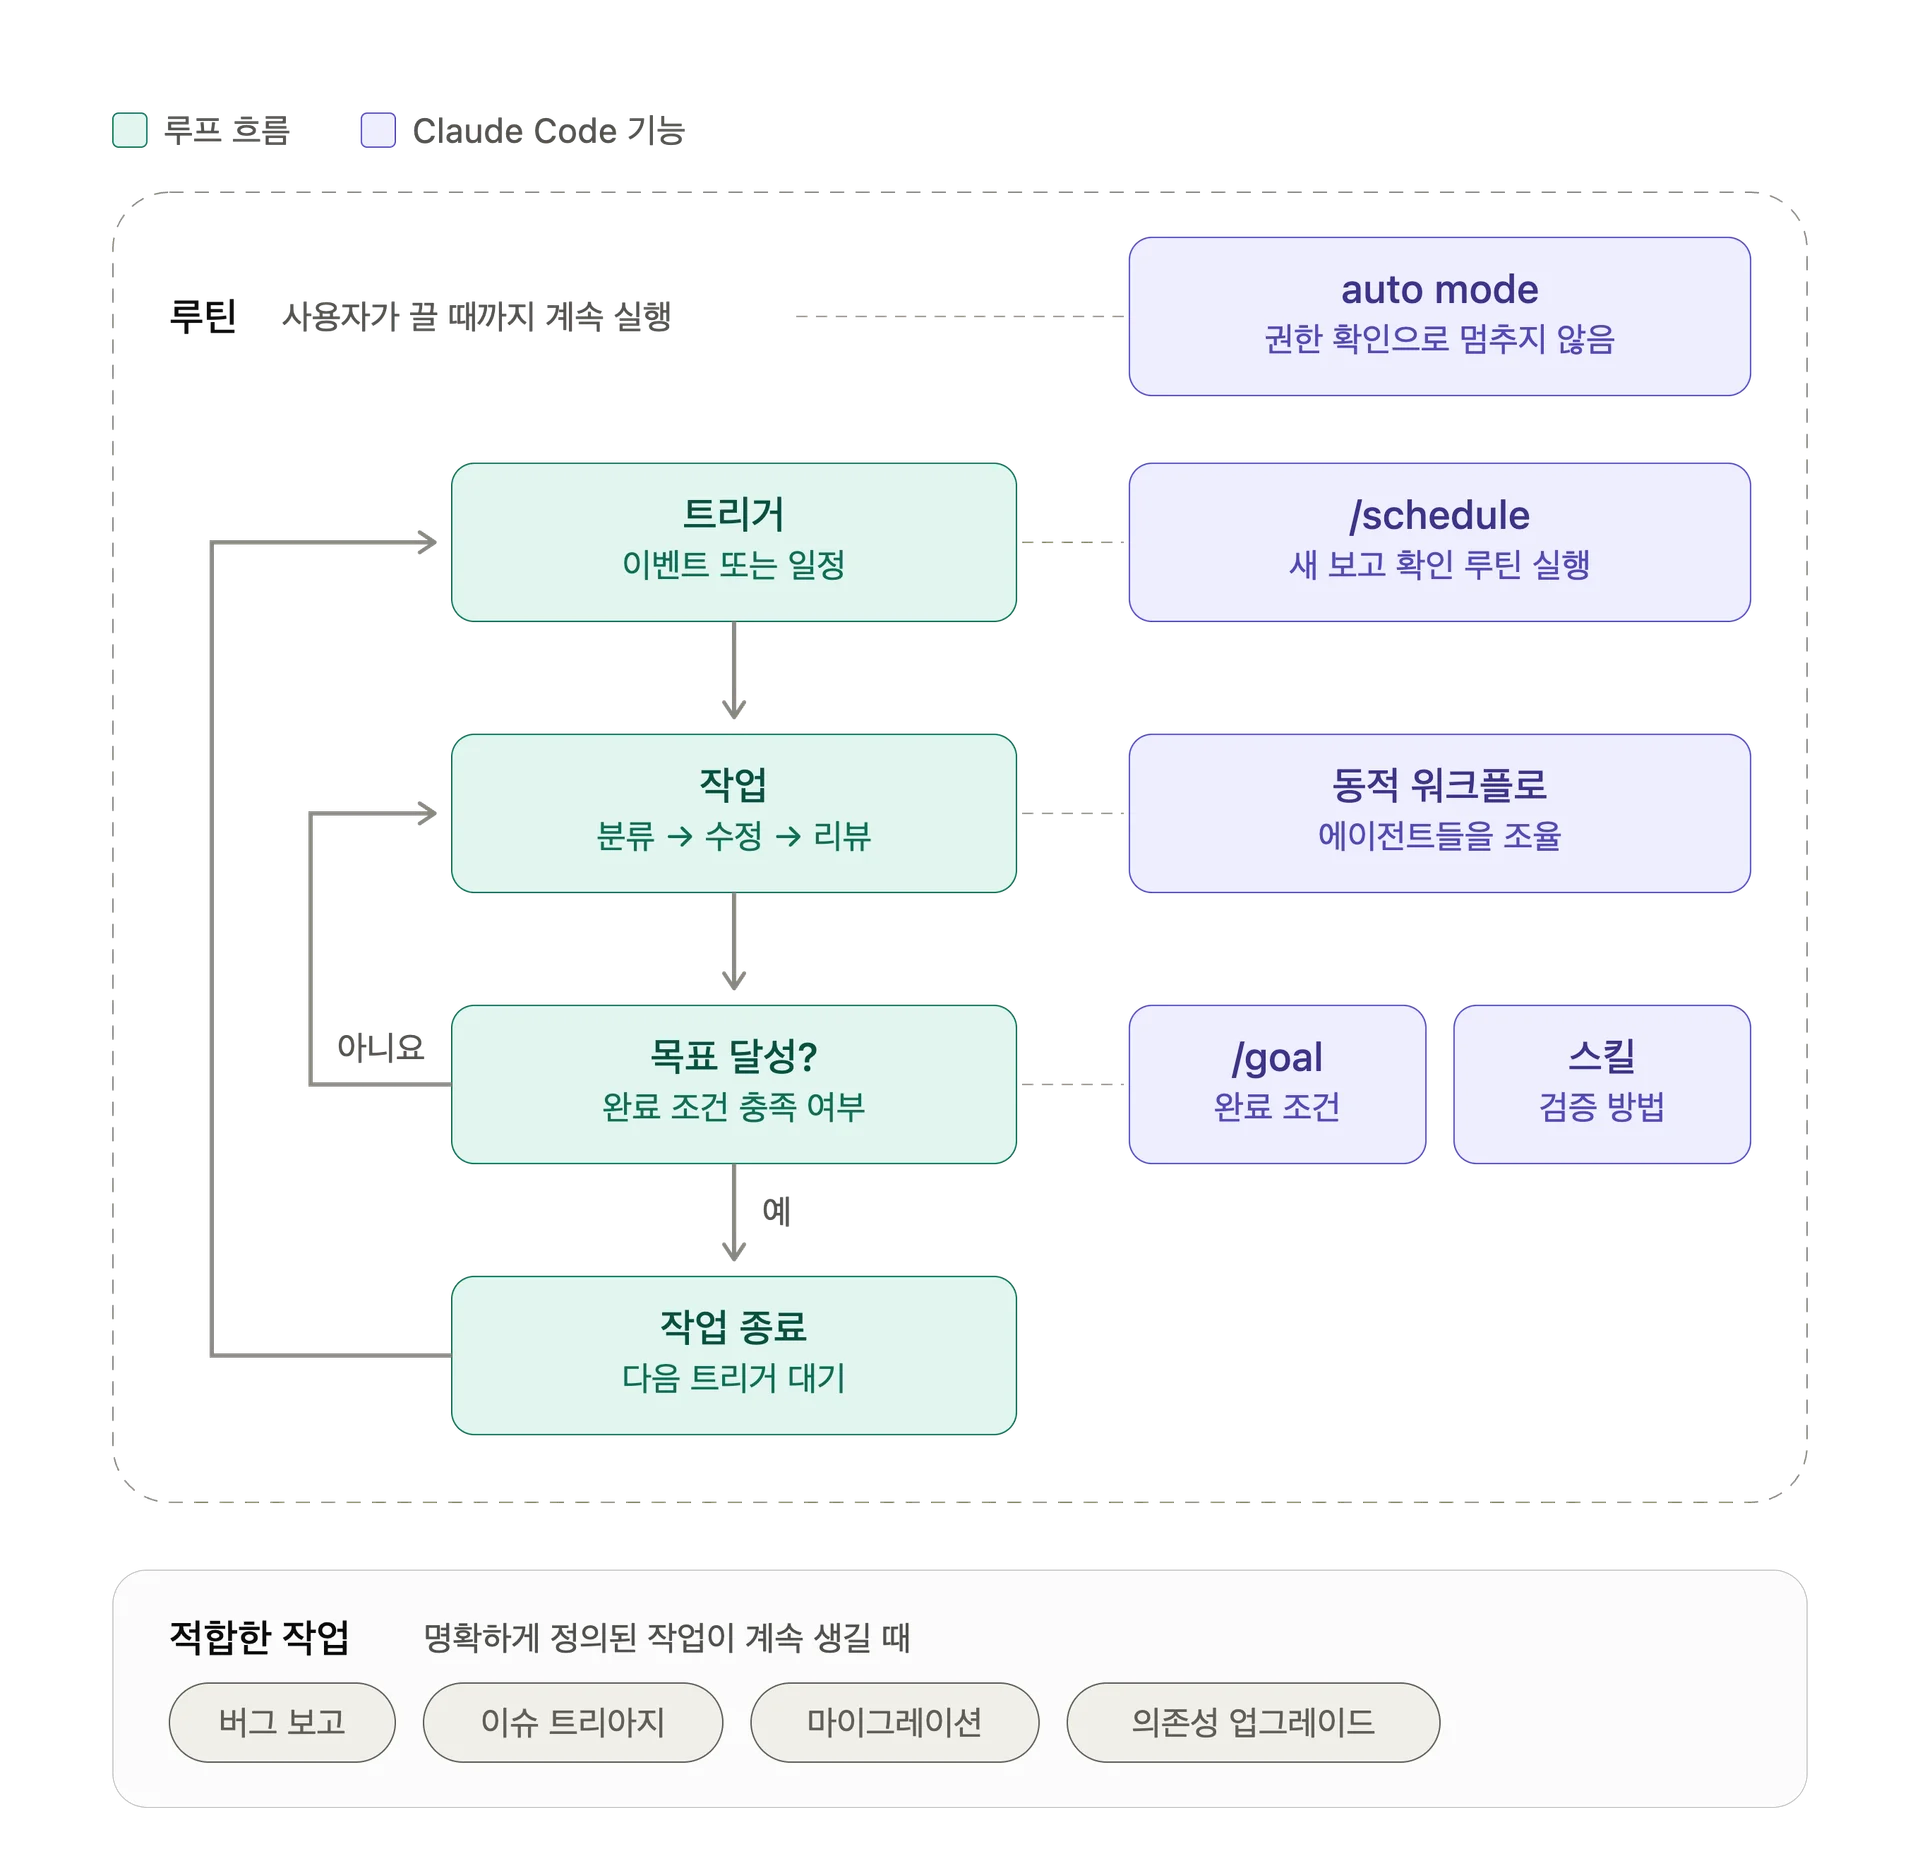
주도적 루프는 앞서 살펴본 기능들에 auto mode, 동적 워크플로 같은 다른 Claude Code 기능을 조합해 사람이 실시간으로 개입하지 않아도 이벤트나 일정에 따라 실행되는 루프입니다. 트리거는 이벤트나 일정이고, 루프 안의 각 작업은 목표를 달성하면 끝나며, 루틴 전체는 사용자가 끌 때까지 계속 실행됩니다. 버그 보고, 이슈 트리아지, 마이그레이션, 의존성 업그레이드처럼 명확하게 정의된 작업이 계속 생길 때 적합합니다.
Claude Code에서는 /schedule로 새 보고를 확인하는 루틴을 돌리고, /goal로 완료 조건을 정의하고 스킬로 검증 방법을 문서화하며, 동적 워크플로로 각 보고를 분류하고 고친 뒤 그 수정을 리뷰하는 에이전트들을 조율하고, auto mode로 사람에게 권한을 묻느라 멈추지 않고 루틴이 돌게 하는 식으로 조합할 수 있습니다.
Claude Code 팀은 다음 예시 프롬프트를 제시합니다. 이 프롬프트에서는 /schedule로 매시간 실행되는 트리거를 만들고, /goal로 목표를 지정한 것을 확인할 수 있습니다.
/schedule every hour: check #project-feedback for bug reports. /goal: don't stop until every report found this run is triaged, actioned, and responded to. When fixing a bug, use a workflow to explore three solutions in parallel worktrees and have a judge adversarially review them.

(매시간 #project-feedback 채널에서 버그 보고를 확인하고, 이번 실행에서 찾은 모든 보고를 분류·조치·회신할 때까지 멈추지 말 것. 버그를 고칠 때는 워크플로로 병렬 워크트리에서 세 가지 해법을 탐색하고 판정자가 적대적으로 리뷰하게 할 것)
네 가지 유형을 표로 정리하면 다음과 같습니다. Claude Code 팀이 유형별로 함께 제시한 사용량 관리 방법도 덧붙였습니다.
| 루프 유형 | 트리거 | 정지 조건 | 적합한 작업 | Claude Code 기능 | 사용량 관리 |
|---|---|---|---|---|---|
| 턴형 루프 | 사용자 프롬프트 | Claude가 작업을 완료했거나 추가 컨텍스트가 필요하다고 판단할 때 | 정기적인 프로세스나 일정에 속하지 않는 비교적 짧은 작업 | 기본 동작(별도 명령어 없음), 검증 스킬 | 구체적인 프롬프트, 스킬로 검증을 강화해 턴 수 줄이기 |
| 목표형 루프 | 사용자가 실시간으로 직접 입력하는 프롬프트 | 목표 달성 또는 완료 조건에 적어 둔 최대 턴 수 도달 | 테스트 통과처럼 검증 가능한 종료 기준이 있는 작업 | /goal | 구체적인 완료 조건과 턴 상한 지정 |
| 시간형 루프 | 시간 간격 | 사용자 취소. /loop는 컴퓨터를 끄거나 세션이 종료되면 멈추고 7일이 지나면 자동 만료되며, 간격을 생략한 경우 작업이 끝나면 Claude가 스스로 끝낼 수 있음 | 입력만 바뀌는 반복 작업, 외부 시스템을 주기적으로 확인해 반응하는 작업 | /loop(세션 안), /schedule(클라우드 루틴) | 간격을 길게 잡거나, 시간 대신 이벤트에 반응 |
| 주도적 루프 | 이벤트 또는 일정(사람의 실시간 개입 없음) | 각 작업은 목표 달성 시 종료, 루틴은 사용자가 끌 때까지 실행 | 명확하게 정의된 작업이 계속 생기는 경우 | 앞의 기능 전부(검증 스킬, /goal, /loop, /schedule)와 동적 워크플로, auto mode | 루틴은 더 작고 빠른 모델로, 판단이 필요한 곳에는 가장 성능이 좋은 모델 |
Claude Code /goal 분석
네 가지 루프 유형 중 목표형 루프를 명령어 하나로 제공하는 /goal을 자세히 들여다보겠습니다.
/goal이란 무엇인가요?
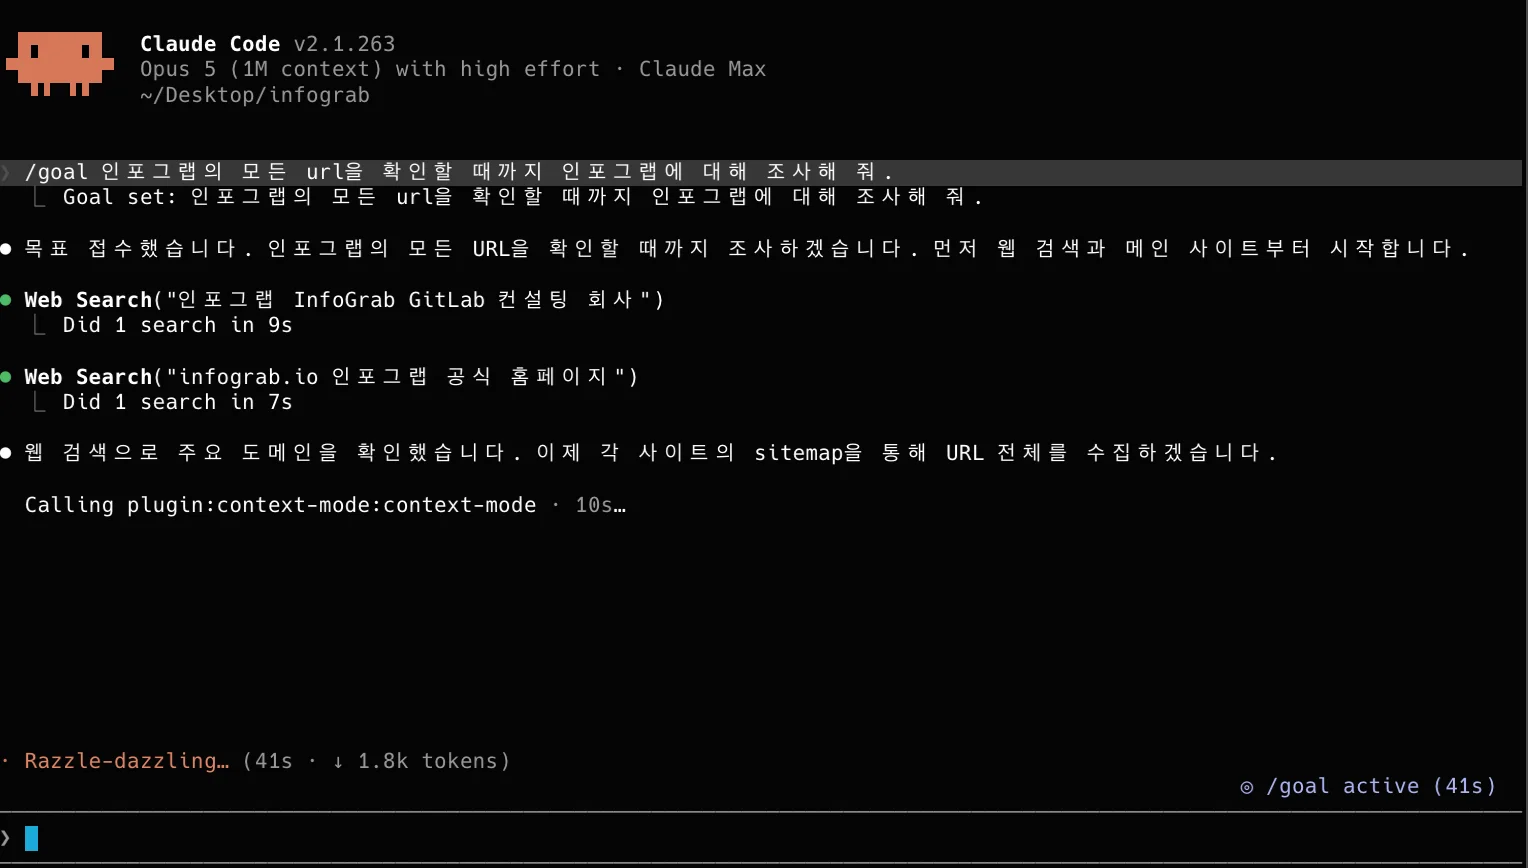
/goal은 완료 조건을 설정해 두면 그 조건이 충족될 때까지 Claude가 턴을 이어 가게 하는 Claude Code 명령어입니다.
매 턴이 끝날 때마다 소형 모델(Claude API 기본값은 Haiku)이 조건 충족 여부를 판정하고, 아직 충족하지 못했으면 판정 이유를 다음 턴의 지침으로 넘겨 Claude가 사용자에게 제어권을 돌려주는 대신 새로운 턴을 시작합니다. 조건이 충족되면 goal은 자동으로 해제되고, 평가 모델이 조건을 충족할 수 없다고 판정하거나 사용자가 직접 고쳐야 하는 오류로 턴이 실패해도 해제됩니다.
이 명령어는 검증 가능한 종료 상태가 있는 큰 작업을 수행할 때 활용하면 좋습니다. 각 모듈이 크기 상한선 아래로 내려갈 때까지 큰 파일을 역할별 모듈로 분리하거나, 설계 문서에 적힌 대로 기능을 구현해 모든 인수 조건을 충족할 때까지 개발하는 게 그 예죠.
auto mode와 권한 모드
Claude Code에서 auto mode가 켜져 있으면 /goal이 필요 없다고 생각할 수도 있습니다. 그러나 두 기능은 다음 측면에서 서로 구분되며, 상호 보완적 역할을 합니다.
| 기능 | 하는 일 | 하지 않는 일 |
|---|---|---|
| auto mode | 한 턴 안의 도구 호출을 분류기가 검토해 안전한 호출은 자동 승인하고 위험한 호출은 막아 도구마다 뜨던 일상적인 승인 요청을 없앰 | 새 턴을 시작하지 않음. Claude가 작업이 끝났다고 판단하면 멈춤 |
/goal | 턴이 끝날 때마다 별도 모델이 완료를 판정하고, 미충족이면 새 턴을 시작해 턴마다 넣던 프롬프트를 없앰 | 권한 모드를 바꾸지 않음 |
/goal은 권한 모드를 바꾸지 않습니다. 따라서 어떤 권한 모드에서 이 명령어를 실행하느냐에 따라 루프가 다르게 흘러갑니다. 기본 권한 모드는 플랜과 실행 방식에 따라 다르기에 원하는 모드를 설정해 실행하는 편이 안전합니다.
- 사람 개입 없이 루프를 돌리고 싶다면 auto mode에서
/goal을 실행합니다. 턴마다 넣던 프롬프트는/goal이, 도구마다 뜨던 일상적인 승인 요청은 auto mode가 없애 줍니다. - 도구 호출을 하나씩 확인하며 통제하고 싶다면 manual mode에서 실행합니다. 이때도 턴은 자동으로 이어지지만, 허용하지 않은 도구를 호출할 때마다 Claude가 승인을 기다려 사용자가 응답할 때까지 루프도 멈춥니다. 필요한 도구를 허용 규칙에 미리 등록해 두면 그 도구를 호출할 때는 루프가 멈추지 않습니다. 단,
.git이나.claude같은 보호 경로에 쓰는 동작처럼 허용 규칙이 있어도 승인을 묻는 동작이 있습니다.
사용법
/goal은 뒤에 무엇을 붙이느냐에 따라 설정, 상태 확인, 해제 세 가지 기능을 수행합니다.
/goal <조건>: 조건을 설정합니다. 조건 자체를 지시로 삼아 첫 턴이 바로 시작됩니다. 세션당 goal은 하나만 둘 수 있어 이미 goal이 있으면 새 조건이 기존 조건을 대체합니다./goal: 현재 goal의 조건, 실행 시간, 평가된 턴 수, 토큰 사용량, 최근 판정 이유를 보여 줍니다./goal clear: 조건이 충족되기 전에 goal을 해제합니다.
평가 모델은 명령을 실행하거나 파일을 읽지 않고 대화에 드러난 내용만 보고 판단합니다. 따라서 조건은 Claude의 출력으로 증명할 수 있어야 합니다. 실행 시간을 제한하려면 "or stop after 20 turns"처럼 턴이나 시간 조항을 조건에 함께 적습니다.
/goal은 어떻게 동작하나요?
이제 문서와 세션 기록으로 /goal의 동작을 확인해 보겠습니다. Claude Code 문서에 따르면, /goal은 "세션 범위의 프롬프트 기반 Stop 훅을 감싼 것"입니다. Stop 훅은 Claude가 응답을 마쳤을 때 실행되는 장치입니다. 즉, /goal은 입력한 완료 조건을 평가하는 프롬프트 기반 Stop 훅을 현재 세션에만 걸어 두는 명령어라고 할 수 있습니다.
턴이 끝나면 소형 모델은 다음 세 판정 중 하나를 짧은 이유와 함께 반환합니다.
| 판정 | 동작 |
|---|---|
| Not yet met | Claude가 계속 작업합니다. 판정 이유가 다음 턴의 지침이 됩니다. |
| Met | goal을 해제하고 세션 기록에 achieved 항목을 남깁니다. |
| Impossible | goal을 해제하고 이유와 함께 failed 항목을 남깁니다. |
단, 턴이 끝날 때 서브에이전트나 백그라운드 셸 명령이 실행 중이면 그 턴의 평가는 건너뛰고, 백그라운드 작업 없이 끝나는 다음 턴에 평가합니다. 또 Claude가 도구를 쓰지 않고 평가 모델에 답만 하는 턴이 몇 번 이어지면, 루프를 멈추고 goal은 설정된 채로 제어를 돌려줍니다.
세션 기록에 남는 판정
/goal을 실행하면 세션을 기록하는 JSONL 파일에 "type": "goal_status"인 객체가 남습니다. 공식 문서에 나오지 않는 내부 형식이라 버전에 따라 달라질 수 있으며, 아래 예시는 여러 실행의 세션 기록에서 이 객체를 발췌한 것입니다. goal을 설정한 시점에는 다음과 같은 객체가 기록됩니다.
{
  "type": "goal_status",
  "met": false,
  "sentinel": true,
  "condition": "test 디렉터리의 모든 테스트가 통과한다. ... 또는 4턴 후 중단한다"
}
다음은 Not yet met 판정입니다. "met": false와 함께 판정 이유가 적혀 있고, 이 이유를 지침으로 다음 턴이 시작됩니다.
{
  "type": "goal_status",
  "met": false,
  "condition": "python3 -m unittest discover -s test 를 실행해 OK 출력을 보인다. 테스트 파일은 수정하지 않는다. 또는 8턴 후 중단한다",
  "reason": "테스트 출력에서 'FAILED (failures=1)'이 표시되었습니다. 조건은 'OK 출력을 보인다'를 요구하지만, 현재 상태는 test_2_sub가 실패 중입니다. 또한 이것은 1턴이므로 '8턴 후 중단'에도 도달하지 않았습니다."
}
Met 판정에는 조건 충족 여부와 판정 이유에 더해 반복 횟수, 소요 시간, 토큰 사용량 같은 계측값이 함께 남습니다. "met": true로 goal이 달성됐음을 확인할 수 있습니다.
{
  "type": "goal_status",
  "met": true,
  "condition": "test 디렉터리의 모든 테스트가 통과한다. ...",
  "reason": "트랜스크립트에서 'python3 -m unittest discover -s test' 명령 실행 결과가 'OK' 출력을 보여줍니다: 'Ran 2 tests in 0.000s\n\nOK'. 또한 테스트 파일(test_calc.py)은 수정하지 않았고, calc.py의 add 함수만 수정했습니다.",
  "iterations": 1,
  "durationMs": 40883,
  "tokens": 2176
}
Impossible 판정은 "failed": true로 불가능을 표시하고, 계측값을 함께 남깁니다.
{
  "type": "goal_status",
  "met": false,
  "failed": true,
  "condition": "python3 -m unittest discover -s test 를 실행해 OK 출력을 보인다. test/ 아래 테스트 파일은 절대 수정하거나 삭제하지 않는다. 또는 5턴 후 중단한다",
  "reason": "The unittest output shows 'FAILED (failures=1)' with AssertionError: 2 != 3, not 'OK'. The condition requires 'OK' output from `python3 -m unittest discover -s test`, but the test contains a self-contradictory assertion: `self.assertEqual(add(1, 1), 2)` followed by `self.assertEqual(add(1, 1), 3)` on the same function call, which is logically impossible to satisfy without modifying the test file.",
  "iterations": 1,
  "durationMs": 52723,
  "tokens": 3739
}
/goal 구현해 보기
실제 코드는 공식적으로 공개되지 않았기에 /custom-goal 명령어로 같은 동작을 직접 구현하고 실행까지 해 보겠습니다. 실제 /goal은 프롬프트 기반 Stop 훅이지만, 이 구현은 명령 타입 Stop 훅에서 claude -p로 평가 모델을 호출해 세부 동작은 다를 수 있습니다. 내장 명령어는 실행할 수 있지만 커스텀 훅으로는 실행할 수 없는 동작은 우회해 구현했습니다. 구현은 파일 세 개와 설정 하나로 이뤄지며, 아래에는 각 파일의 핵심 부분만 옮겼습니다.
| 파일 | 역할 |
|---|---|
.claude/commands/custom-goal.md | /custom-goal 슬래시 명령 정의 |
.claude/hooks/custom-goal-set.sh | 조건 설정, 상태 조회, 해제와 상태 파일 관리 |
.claude/hooks/custom-goal-eval.sh | 턴이 끝날 때마다 평가자 호출과 판정 처리 |
.claude/settings.json | Stop 훅 등록 |
1단계: 슬래시 명령 정의
/custom-goal을 입력하면 Claude는 아래 마크다운 파일의 지시에 따라 동작합니다. 앞부분의 셸 블록이 인수를 status, clear, set으로 나누어 custom-goal-set.sh를 호출하고, 뒷부분이 그 출력에 따라 Claude가 할 일을 정합니다.
.claude/commands/custom-goal.md
---
description: "완료 조건을 정하고 충족될 때까지 계속 작업합니다"
argument-hint: "<조건> [--max-turns N] | status | clear"
allowed-tools: ["Bash(${CLAUDE_PROJECT_DIR}/.claude/hooks/custom-goal-set.sh:*)"]
---

# custom-goal
실행 블록은 백틱 세 개 뒤에 느낌표를 붙여 엽니다. 그 안에 아래 명령을 넣습니다.
"${CLAUDE_PROJECT_DIR}/.claude/hooks/custom-goal-set.sh" $( \
  case "$ARGUMENTS" in \
    "")       echo "status" ;; \
    status)   echo "status" ;; \
    clear)    echo "clear" ;; \
    *)        echo "set ${CLAUDE_SESSION_ID} $ARGUMENTS" ;; \
  esac )
실행 블록을 백틱 세 개로 닫은 다음, 아래 지시문이 이어집니다.
## 다음에 할 일

위 출력을 보고 판단하세요.
- **`custom-goal 설정됨`이 보이면**: 지금부터 그 조건을 향해 작업을 시작하세요. 조건에 적힌 증명 방법(테스트 명령 등)을 실제로 실행하고, 그 출력이 대화에 남게 하세요. 매 턴이 끝날 때마다 별도의 평가 모델이 대화만 읽고 조건 충족 여부를 판정합니다. 평가자는 명령을 실행하거나 파일을 읽을 수 없으므로, 당신이 실행하지 않은 검사는 판정에 반영되지 않습니다. 아직 충족되지 않았다는 판정이 나오면 그 이유가 다음 턴의 지시로 돌아옵니다.
- **상태 조회 결과가 보이면**: 그 내용을 사용자에게 그대로 전달하고 멈추세요.
- **`해제했습니다`가 보이면**: 그대로 전달하고 멈추세요.
- **오류가 보이면**: 오류 내용을 전달하고 멈추세요.
2단계: 상태 파일 관리
custom-goal-set.sh는 상태 파일을 만들고 관리합니다. 훅은 턴마다 새 프로세스로 실행돼 이전 턴의 정보를 기억하지 못하기에 턴 사이에 컨텍스트를 이어 가도록 상태 파일을 둡니다.
# .claude/hooks/custom-goal-set.sh 일부
started_ms=$(python3 -c 'import time; print(int(time.time() * 1000))')

jq -n \
  --arg condition "$condition" \
  --arg session_id "$session_id" \
  --arg eval_model "$eval_model" \
  --argjson max_turns "$max_turns" \
  --argjson started_ms "$started_ms" \
  '{
    condition:     $condition,
    session_id:    $session_id,
    eval_model:    $eval_model,
    max_turns:     $max_turns,
    turns:         0,
    started_ms:    $started_ms,
    eval_tokens:   0,
    eval_cost_usd: 0,
    last_verdict:  "",
    last_reason:   ""
  }' > "$STATE_FILE"
각 필드의 용도는 다음과 같습니다.
| 필드 | 용도 |
|---|---|
condition | 평가자에게 매번 넘길 조건 원문 |
session_id | 세션 범위를 지키기 위한 소유자 표시 |
eval_model | 평가에 쓸 모델 |
max_turns, turns | 결정론적 턴 상한 |
started_ms | 종료 시점에 durationMs를 계산할 기준 |
eval_tokens, eval_cost_usd | 턴을 넘어 누적되는 평가 비용 |
last_verdict, last_reason | 상태 조회에 보여 줄 최근 판정 |
3단계: 평가 훅 작성
루프를 구현하는 핵심 파일은 custom-goal-eval.sh입니다. 실제 코드는 턴 상한, 백그라운드 작업 처리 유예, 재귀 방지 같은 예외 처리가 대부분을 차지하지만, 여기서는 핵심 부분만 옮겼습니다.
먼저 출력 함수 두 개를 정의합니다. emit_block은 Claude Code의 Stop 훅 규약에 맞춰 decision: "block"을 출력해 Claude가 멈추지 못하게 하고, 평가자의 판정을 reason에 담아 Claude가 새 턴에서 할 일을 지정합니다. emit_stop은 decision 없이 systemMessage만 출력해 사용자에게 한 줄을 알리고 턴을 끝냅니다.
emit_block() {   # 계속 작업시킨다. reason이 다음 턴의 지시가 된다.
  jq -n --arg reason "$1" '{decision: "block", reason: $reason}'
  exit 0
}
emit_stop() {    # 멈추게 두고 사용자에게 한 줄 알린다.
  jq -n --arg msg "$1" '{systemMessage: $msg}'
  exit 0
}
다음은 평가자를 호출하는 부분입니다. 판정 규칙을 프롬프트로 정의하고, EVAL_CMD에서 claude -p로 모델을 호출합니다. 평가 모델이 응답하지 못하면 판정을 건너뛰고 멈추게 하는 예외 처리도 포함합니다.
JUDGE_PROMPT=$(cat <<EOF
당신은 완료 조건 평가자입니다. 아래 대화 기록만 근거로 조건 충족 여부를 판정하세요.
명령을 실행하거나 파일을 읽을 수 없습니다. 대화에 드러나지 않은 것은 충족되지 않은 것으로 봅니다.
<조건>
${CONDITION}
</조건>
<대화 기록>
${EVIDENCE}
</대화 기록>
판정 규칙:
- 조건이 충족됐다는 증거가 대화에 있으면: {"ok": true, "reason": "무엇이 충족을 증명하는지"}
- 아직이면: {"ok": false, "reason": "무엇이 남았고 다음에 무엇을 해야 하는지"}
- 결코 충족될 수 없으면: {"ok": false, "impossible": true, "reason": "이유"}
reason은 한국어 한두 문장으로 씁니다. 다른 설명 없이 JSON 객체 하나만 출력하세요.
EOF
)
# --output-format json 을 쓰면 판정문과 함께 토큰 사용량이 돌아온다.
EVAL_CMD=(claude -p --model "$EVAL_MODEL" --output-format json "$JUDGE_PROMPT")
if command -v timeout >/dev/null 2>&1; then
EVAL_CMD=(timeout 120 "${EVAL_CMD[@]}")
elif command -v gtimeout >/dev/null 2>&1; then
EVAL_CMD=(gtimeout 120 "${EVAL_CMD[@]}")
fi
ENVELOPE=$(CUSTOM_GOAL_EVAL=1 "${EVAL_CMD[@]}" 2>/dev/null)
# (생략) ENVELOPE에서 판정문 본문을 RAW로, 토큰 사용량을 TOTAL_TOKENS와 TOTAL_COST로 추출한다.
# 모델이 JSON을 ```json 펜스로 감싸는 경우가 많아, 펜스와 상관없이 마지막 JSON 객체만 뽑아 파싱한다.
VERDICT_JSON=$(tr -d '\n' <<<"$RAW" | grep -o '{[^{}]*}' | tail -n 1)
# 평가자가 응답하지 못했으면 판정을 포기하고 멈추게 둔다.
if [[ -z "$VERDICT_JSON" ]] || ! jq -e . >/dev/null 2>&1 <<<"$VERDICT_JSON"; then
log "evaluator returned no parsable JSON: ${RAW:0:200}"
emit_stop "◎ custom-goal: 평가자 응답을 해석하지 못해 이번 턴은 판정을 건너뜁니다. goal은 유지됩니다."
fi
OK=$(jq -r '.ok // false' <<<"$VERDICT_JSON")
IMPOSSIBLE=$(jq -r '.impossible // false' <<<"$VERDICT_JSON")
REASON=$(jq -r '.reason // ""' <<<"$VERDICT_JSON")
판정에 따라 분기합니다. Met이나 Impossible이면 앞서 정의한 emit_stop으로 루프를 끝내고, 사용자에게 목표 달성 또는 달성 불가능을 알립니다.
if [[ "$OK" == "true" ]]; then
  record_status true "$REASON" 1
  rm -f "$STATE_FILE"
  log "MET after $NEXT_TURN turns: $REASON"
  emit_stop "◎ custom-goal 달성 (${NEXT_TURN}턴): ${REASON}"
fi

if [[ "$IMPOSSIBLE" == "true" ]]; then
  record_status false "$REASON" 1
  rm -f "$STATE_FILE"
  log "IMPOSSIBLE after $NEXT_TURN turns: $REASON"
  emit_stop "◎ custom-goal 해제: 조건을 만족시킬 수 없다고 판정했습니다. 이유: ${REASON}"
fi
Not yet met이면 턴 수와 판정 이유를 상태 파일에 저장하고, emit_block으로 루프를 이어 갑니다.
# 아직 충족되지 않음. 턴 수와 판정 이유를 저장하고 계속 작업시킨다.
record_status false "$REASON" 0

tmp=$(mktemp)
jq --argjson turns "$NEXT_TURN" \
   --arg verdict "not_yet_met" \
   --arg reason "$REASON" \
   --argjson tokens "$TOTAL_TOKENS" \
   --argjson cost "$TOTAL_COST" \
   '.turns = $turns | .last_verdict = $verdict | .last_reason = $reason
    | .eval_tokens = $tokens | .eval_cost_usd = $cost' \
   "$STATE_FILE" > "$tmp" && mv "$tmp" "$STATE_FILE"

log "NOT_YET_MET turn $NEXT_TURN/$MAX_TURNS: $REASON"

emit_block "[custom-goal ${NEXT_TURN}/${MAX_TURNS}] 완료 조건이 아직 충족되지 않았습니다.

조건: ${CONDITION}

평가자 판정: ${REASON}

위 판정을 근거로 작업을 계속하세요. 조건의 증명 방법을 실제로 실행해서 그 결과가 대화에 남게 하세요. 평가자는 도구를 쓸 수 없고 당신이 출력한 것만 봅니다."
4단계: Stop 훅 등록
마지막으로 .claude/settings.json에 Stop 훅을 등록하면 /custom-goal을 실행할 준비가 끝납니다.
{
  "hooks": {
    "Stop": [
      {
        "hooks": [
          {
            "type": "command",
            "command": "\"${CLAUDE_PROJECT_DIR}/.claude/hooks/custom-goal-eval.sh\"",
            "timeout": 150
          }
        ]
      }
    ]
  }
}
동작 확인
이제 /custom-goal의 동작을 확인해 보겠습니다. 실행 환경은 Claude Code v2.1.266, Opus 5입니다. 완료 조건의 핵심은 "python3 -m unittest discover -s test를 실행해 OK 출력을 보인다"이고, 조건에 "test/ 아래 파일은 수정하지 않는다"는 제약을 넣어 Claude가 테스트 파일을 고쳐서 통과시키면 조건 위반이 되게 했습니다. 턴 상한은 --max-turns 6으로 걸었습니다. 반복 과정을 쉽게 확인하기 위해 실패를 한 턴에 하나씩만 고치고, 고칠 때마다 첫 실패에서 멈추는 -f 옵션으로 테스트를 실행해 출력을 보고한 뒤 응답을 마치도록 지시했습니다. 이 지시도 인수에 함께 들어가 조건의 일부로 저장됐기 때문에 평가자는 실패를 하나씩 고쳤는지도 함께 판정했습니다.
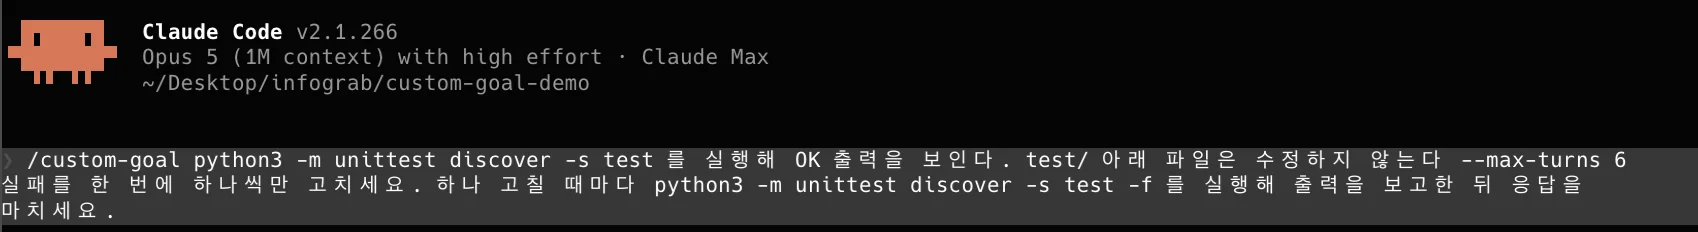
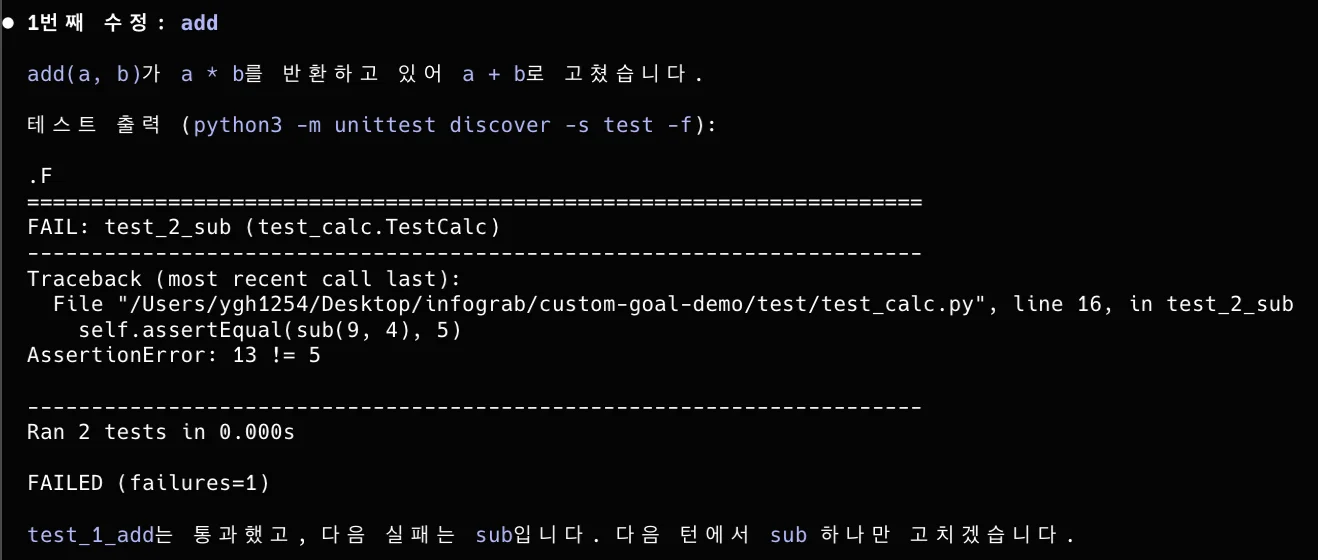
첫 턴에서 Claude는 add 함수가 a * b를 반환하던 것을 a + b로 고친 뒤 테스트를 실행했습니다. -f 옵션 때문에 첫 실패인 test_2_sub에서 실행이 멈춰 2개 테스트만 돌았고, 결과는 FAILED입니다. Claude는 다음 실패가 sub라고 보고하고 응답을 마쳤습니다.
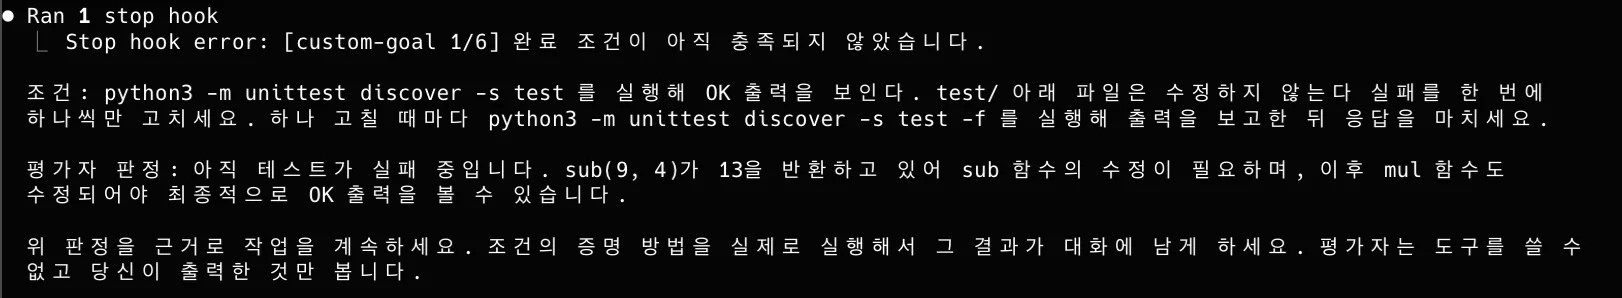
턴이 끝나자 Stop 훅이 실행됐습니다. 평가자는 테스트가 아직 실패 중이며 sub와 mul을 더 고쳐야 한다고 판정했고, custom-goal-eval.sh는 이 판정을 emit_block의 reason에 담아 돌려보냈습니다. 화면에는 Stop hook error로 표시되지만 오류가 아니라 block 판정의 내용으로, 조건과 평가자 판정, 계속 작업하라는 지시가 그대로 보입니다. 앞머리의 [custom-goal 1/6]은 턴 상한 6 중 1턴을 썼다는 뜻입니다.
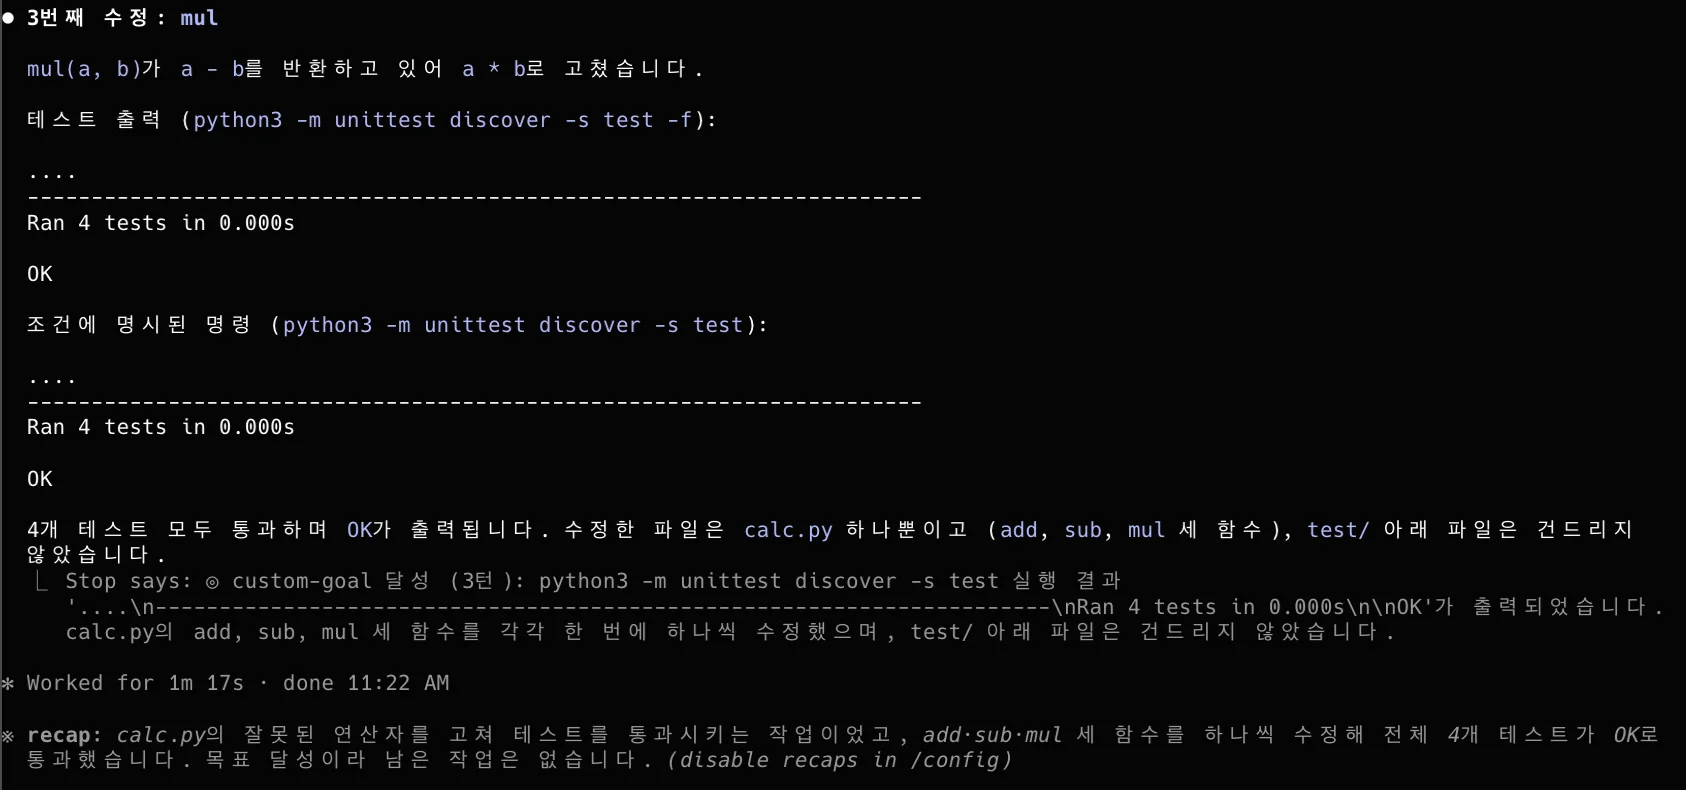
같은 과정이 반복돼 2턴에서 sub, 3턴에서 mul을 고쳤습니다. 3턴에서는 -f 옵션 실행과 조건에 명시된 명령 실행 모두 4개 테스트가 통과해 OK가 출력됐고, Claude는 calc.py만 수정했으며 test/ 아래 파일은 건드리지 않았다고 보고했습니다. 평가자가 Met 판정을 내리자 emit_stop의 systemMessage가 "custom-goal 달성 (3턴)"으로 표시되며 루프가 종료됐습니다. 전체 소요 시간은 1분 17초였습니다.
맺음말
지금까지 루프 엔지니어링의 정의와 루프의 유형을 살펴보고, /goal을 분석한 뒤 Stop 훅으로 직접 재구현해 보았습니다. 이 과정에서 가장 중요한 요소는 완료 조건이었습니다. 평가 모델은 대화에 드러난 내용만 보고 판정하기에 '테스트 통과'나 '벤치마크 출력에서 확인한 지연 시간 100ms 이하'처럼 측정 가능하고 Claude의 출력으로 증명할 수 있는 조건이어야 루프가 제대로 돕니다. Claude Code 문서도 측정 가능한 종료 상태 하나, 그것을 증명할 방법, 지켜야 할 제약을 조건에 담으라고 권합니다.
완료 조건에서 보듯, 루프를 설계하는 일은 동작 사이클을 만드는 일이라기보다 멈추는 방법과 예외를 다루는 일에 가깝습니다. 앞서 구현한 custom-goal도 실제 코드의 대부분은 턴 상한, 백그라운드 작업 유예, 평가자 응답 실패 처리 같은 예외 처리였고, /goal 역시 해제와 중단 조건을 여러 갈래로 두고 있습니다. 이렇게 설계와 운영에 품이 드는 만큼, 모든 작업에 복잡한 루프를 둘 필요는 없습니다. Claude Code 팀은 가장 단순한 해법에서 시작해 이런 패턴을 선택적으로 도입하라고 권하고, Osmani도 에이전트에 직접 프롬프트를 입력하는 방식이 여전히 유효하니 균형을 찾으라고 말합니다.
반대로 /goal 하나로는 담기 어려운 작업도 있습니다. /goal은 조건 하나를 향해 도는 단일 루프라, 어떤 단계를 어떤 순서로 거칠지는 Claude의 판단에 맡겨집니다. 단계를 미리 나누고 상황에 따라 정해진 경로로 보내야 하는 일이라면, 단계와 분기 경로를 그래프로 명시해 에이전트가 그 경로를 따르도록 통제하는 접근을 쓸 수 있는데, LangChain은 이를 그래프 엔지니어링이라고 부릅니다.
Osmani의 말로 글을 마무리하겠습니다. 그는 같은 루프를 만들어도, 깊이 이해하는 작업을 더 빨리 처리하려고 쓰는 사람과 작업을 이해하지 않으려고 쓰는 사람은 정반대의 결과를 얻는다고 말합니다. 그래서 루프를 만들되, 실행 버튼만 누르는 사람이 아니라 엔지니어로 남으라고 당부하죠. 이 글을 준비하며 저도 비슷한 생각을 했습니다. 도입부에서 짚었듯 사람이 루프 한가운데서 매 턴을 확인하고 다시 지시하던 일은 이제 시스템에 맡길 수 있습니다. 그러나 무엇을 완료로 볼지 조건을 설계하고, 루프가 내놓은 최종 결과를 검증하는 일은 여전히 엔지니어의 몫입니다. 여러분의 반복 업무 하나를 골라 훅과 스킬로 루프를 직접 만들어 보시길 권합니다. 그 과정에서 루프에 넘길 일과 사람이 쥐고 있어야 할 일, 엔지니어로서 자신이 키워야 할 역량을 발견할 수 있을 겁니다.
코딩 에이전트의 '완료', 무엇으로 판정하고 있나요
에이전트 자동화의 품질과 비용은 무엇을 완료로 보고 언제 멈출지를 얼마나 분명하게 정했는지에 달려 있습니다. 인포그랩이 팀의 개발 흐름과 CI/CD에 맞는 완료 조건, 검증 절차, 권한 운영 기준을 설계하도록 돕습니다.
참고 자료
- “Loop Engineering”, Addy Osmani, https://addyosmani.com/blog/loop-engineering/
- “What Is Loop Engineering?”, IBM, https://www.ibm.com/think/topics/loop-engineering
- “3 Years of Graph Engineering with LangGraph”, LangChain, https://www.langchain.com/blog/3-years-of-graph-engineering-with-langgraph
- “The Art of Loop Engineering”, LangChain, https://www.langchain.com/blog/the-art-of-loop-engineering
- “Building Effective AI Agents”, Anthropic, https://www.anthropic.com/engineering/building-effective-agents
- “Keep Claude working toward a goal”, Claude Code Docs, https://code.claude.com/docs/en/goal
- “Loop engineering: Getting started with loops”, Claude, https://claude.com/blog/getting-started-with-loops
- “claude-code”, GitHub, https://github.com/anthropics/claude-code
- “Loop Engineering とは?Anthropic が示す「プロンプトを書く」から「ループを設計する」への転換 🔁”, NEC Solution Innovators, https://note.nec-solutioninnovators.co.jp/n/n903340ec0af9

Harvey
AI Engineer
InfoGrab의 Software Engineer로서, AI 서비스 구조를 설계하고 시스템을 구축합니다. 다양한 AI 기술을 실무에 도입하여 적극적으로 효율성을 향상시킵니다. 데이터를 통해 고객의 목소리를 이해하고 반영하는 과정을 즐깁니다.
이 저자의 글 모두 보기 →이 글이 도움이 되셨나요?
인포그랩 전문가가 맞춤 상담을 도와드립니다.
관련 글
GitLab CI에 AI 에이전트를 연결할 때 점검할 5가지
코딩 에이전트를 GitLab CI에 연결했다면 CLAUDE.md와 AGENTS.md는 더 이상 문서가 아닙니다. MR 하나로 지시가 바뀌는 이 파일을 CODEOWNERS, 보호 브랜치, CI Job, Protected 변수로 통제하는 다섯 가지 점검 방법을 실습으로 정리했습니다.

AI 에이전트 스킬이 발동하지 않는 이유: SKILL.md 결함과 개선법
AI 에이전트가 스킬을 고르지 않거나 엉뚱한 절차를 밟는다면 SKILL.md를 살펴야 합니다. 실제 파일 238개를 분석한 연구가 찾아낸 결함 유형과 이를 개선하는 8가지 방법, 업무용 스킬 5개에 직접 적용한 결과를 정리했습니다.
에이전트 옵저버빌리티 - AI 에이전트의 '조용한 실패'를 잡는 법
이 글은 에이전트 옵저버빌리티의 개념과 동작 방식, APM·LLM 옵저버빌리티와의 차이, 구현 도구를 살펴봅니다. 아울러 Langfuse와 Google Gemini로 PR 리뷰 에이전트의 활동을 추적·평가하는 실습을 다룹니다. 또 에이전트 옵저버빌리티를 원활하게 운영하기 위해 유념할 사항도 알아봅니다.