

고객의 한마디가 기능이 되기까지, AI 에이전트로 시작하는 제품 개발 사이클
안녕하세요. 인포그랩에서 소프트웨어 엔지니어로 근무하는 Andy입니다.
저는 고객사 자동화 프로젝트를 진행하며 n8n의 워크플로와 운영 데이터를 한곳에서 관리하는 인포그랩의 제품 Nelper를 개발하고 있습니다.
오늘날 AI 코딩 도구가 널리 쓰이면서 기능을 구현하는 속도는 빨라졌습니다. Nelper를 개발할 때도 마찬가지였습니다. 그러나 한계도 있습니다. 고객의 요구사항이 여러 사람과 문서를 거치면서 개발에 고려해야 할 고객의 상황과 맥락이 일부 누락될 때가 있는데요. 그 결과, 고객의 요구사항을 제품에 온전히 반영하기 어려운 상황도 생깁니다. 요구사항을 반영하고, 결과를 검증해 고객 현장에 다시 전달하기까지 시간도 오래 걸리고요.
이에 저는 AI로 코드를 더 빨리 작성하는 것뿐만 아니라, 개발 과정에서 고객 요구사항의 맥락을 잃지 않고 온전히 참고하는 환경을 만드는 데 집중했습니다. 인포그랩의 내부 AI 에이전트인 Nelper Agent는 그 산물 중 하나인데요. 고객의 요구사항이 올라온 Slack 스레드에서 Nelper Agent를 호출하면, 에이전트가 그 대화와 현재 코드, 운영 데이터를 근거로 기술 메모를 정리하도록 했고요. 이 기술 메모를 출발점으로 구현과 검증, 배포와 공유가 한 흐름으로 이어지고 신속하게 진행되도록 각 단계를 AI 도구와 자동화 환경으로 연결했습니다.
이 글에서는 Nelper를 개발하면서 고객의 요구사항을 기능으로 구현해 고객 현장에 다시 전달하는 과정을 개선한 방법을 다룹니다. 고객의 요구사항을 수집해 정리하는 Nelper Agent, 기능 구현과 검증을 진행하는 개발 환경, merge 이후 문서화와 공유 프로세스를 차례로 소개하고요. 고객의 목소리가 실제 Nelper 기능으로 구현된 사례로 전체 동작 흐름을 보여 드립니다. 마지막으로 대화 맥락 정리와 근거 수집 같은 반복 작업은 자동화하되, 제품의 우선순위와 최종 결과를 판단하는 일은 왜 사람이 맡았는지도 살펴보겠습니다.
고객의 요구사항을 기능으로 잇는 사이클을 어떻게 구성했을까요?
Nelper에서는 고객의 요구사항이 기능으로 구현돼 고객 현장에 다시 전달되기까지 과정이 하나의 제품 사이클입니다. 이 사이클을 이해하려면 Nelper가 어떤 데이터를 다루는지 짚고 가야 합니다.
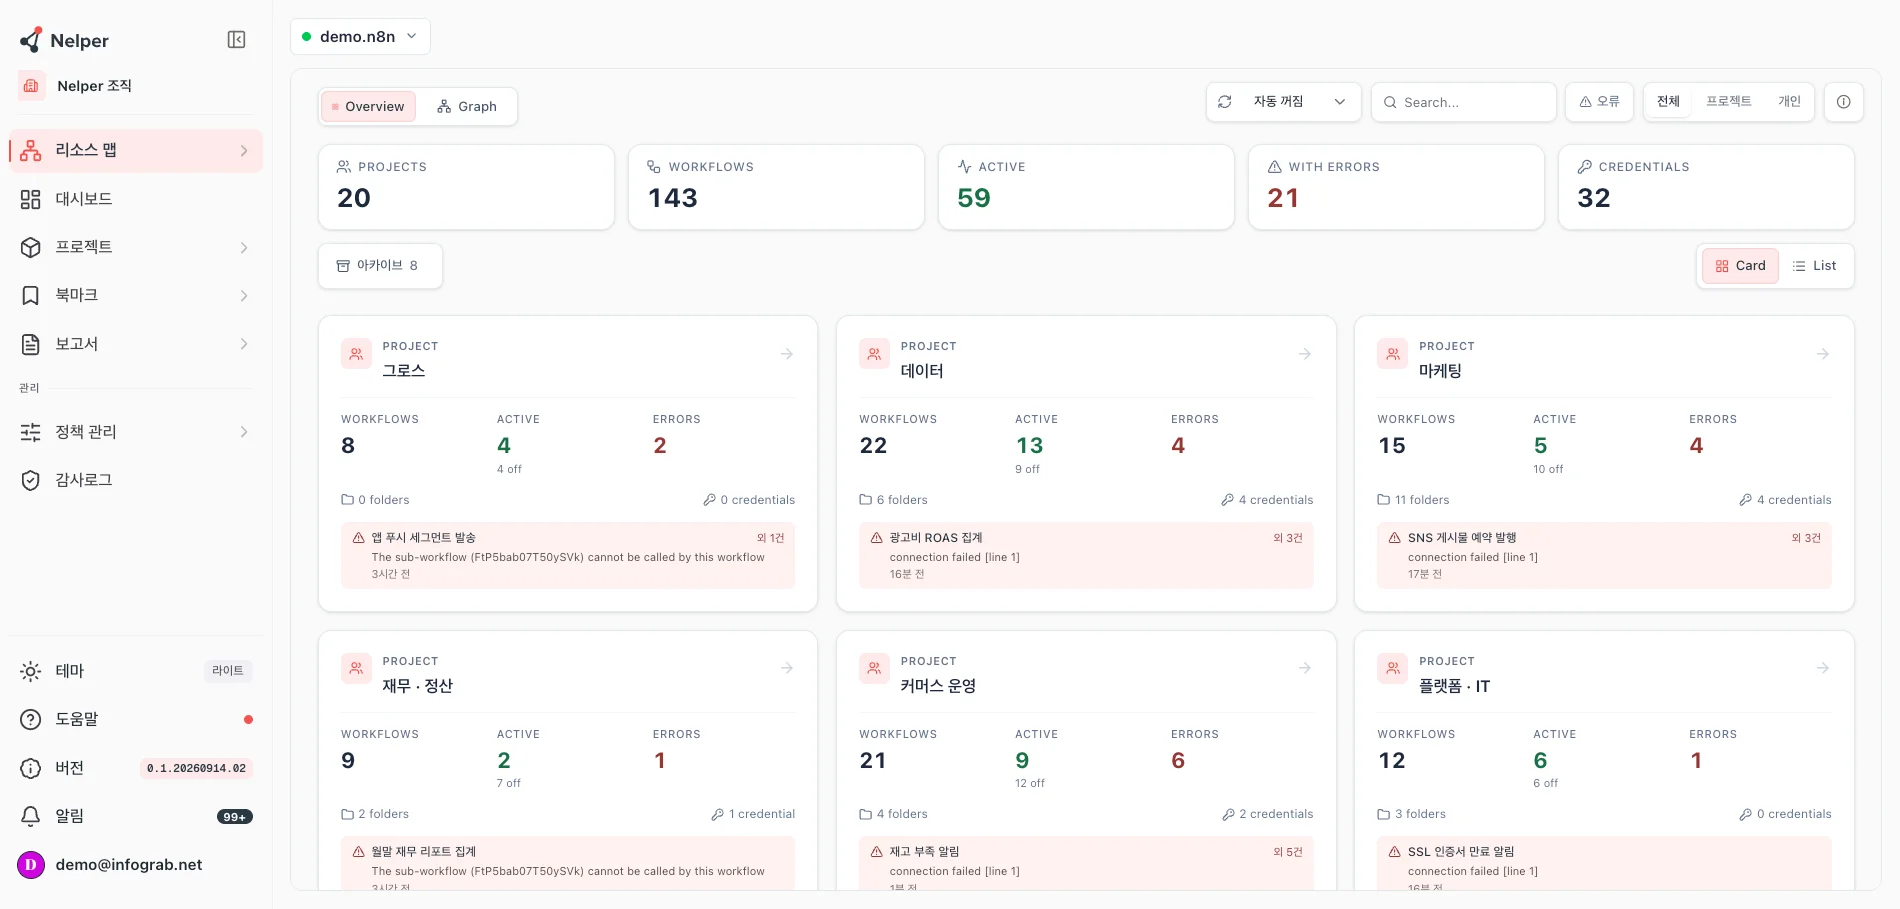
Nelper는 여러 n8n 인스턴스의 워크플로와 함께 실행 이력, 오류, 비용, 라이선스 사용량 같은 운영 데이터를 한곳에서 확인하고 분석하게 해 줍니다. 이 데이터를 바탕으로 조직에서 n8n 운영 문제를 발견하도록 돕죠. n8n만으로는 관리하기 어려운 노드 정책과 네이밍 규칙 같은 관리 기능도 제공합니다.
Nelper에서 가장 중요한 입력은 고객 현장의 목소리입니다. 인포그랩 엔지니어들은 고객과 직접 대면하며 n8n 구축과 자동화 프로젝트를 진행하는데요. 이 과정에서 엔지니어들은 고객과 대화하며 그동안 문서에서 잘 드러나지 않던 생생한 요구사항을 듣게 됩니다.
이런 요구사항을 그 자리에서 현재 제품의 코드와 운영 상태와 함께 분석하면, 요구사항이 다음 중 어느 쪽인지 신속히 판단할 수 있습니다.
- 이미 제품에 있는 기능으로 풀리는 문제라면, 현재 제품의 동작을 근거로 고객에게 해결 방법을 안내합니다.
- 해결 방법이 통할지 확신하기 어렵다면, 데모 환경에서 PoC로 먼저 검증합니다.
- 제품에 없는 기능이 필요하다면, 아이디어로 구조화한 뒤 우선순위를 판단해 실제 구현합니다.
저는 이 판단까지 제품 개발의 일부로 보고 사이클에 고객 대응부터 기획과 PoC, 개발과 검증, 배포와 공유까지 모두 포함했습니다. 각 단계를 하나의 제품 개발 사이클로 연결하지 않으면, 고객 요구사항의 중요한 맥락이 누락될 수 있기 때문입니다. 사이클은 앞단, 뒷단, merge 이후 세 구간으로 이뤄집니다.
| 구간 | 하는 일 | 구성 |
|---|---|---|
| 앞단 | 고객의 요구사항을 수집해 정리 | Nelper Agent |
| 뒷단 | 기능 구현과 검증 | AI가 바로 일할 수 있도록 정리된 저장소와 검증 환경 |
| merge 이후 | 문서화와 공유 | 릴리즈 파이프라인, AI를 활용한 문서 갱신, Nelper Agent로 사내 공유 |
앞단에는 Nelper Agent를 두었습니다
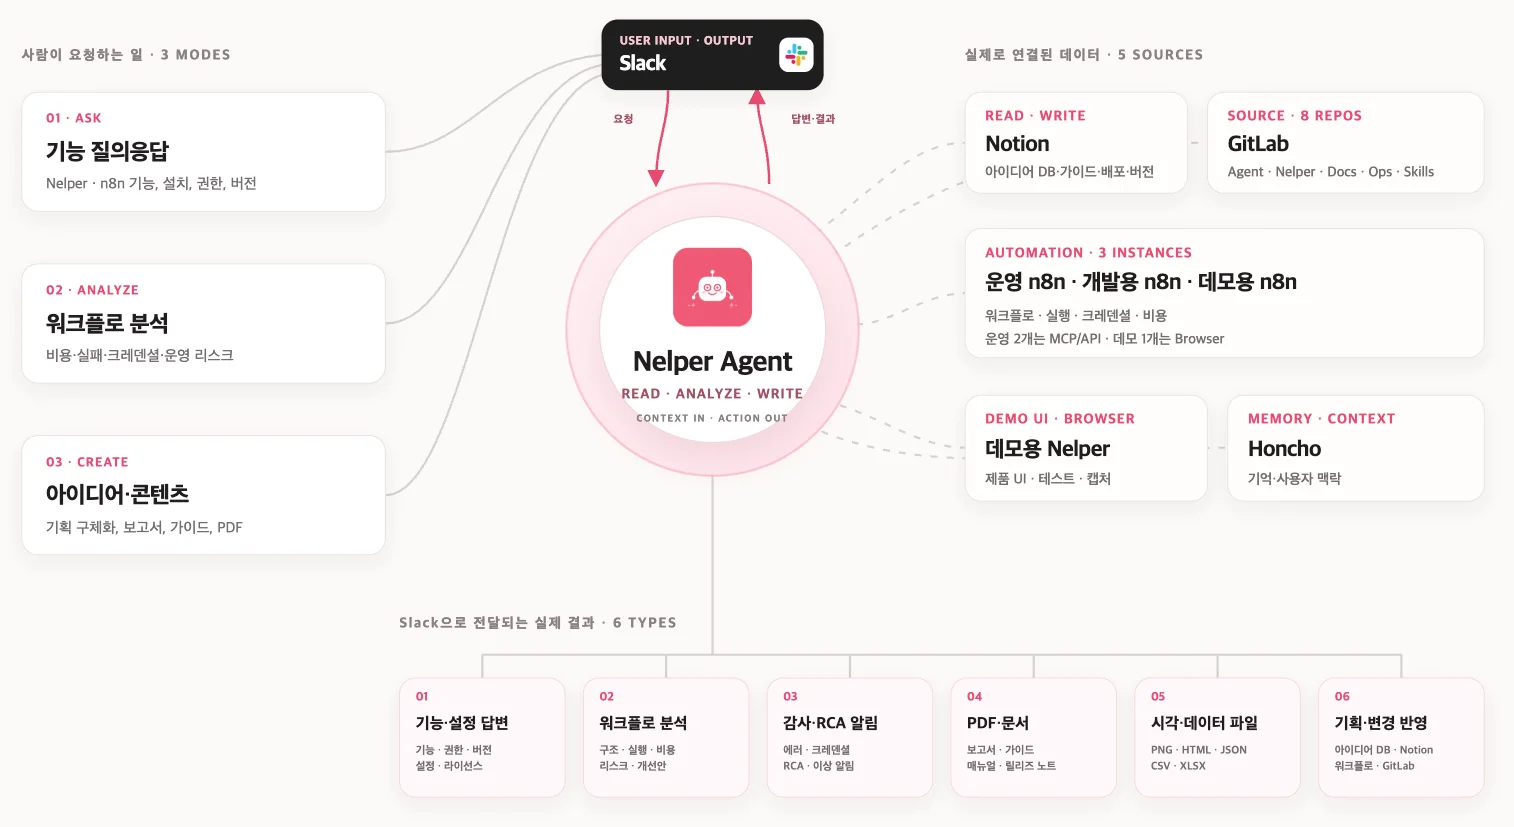
사이클의 첫 구간에서 고객의 요구사항을 수집해 정리하는 일은 Nelper Agent가 맡습니다. Nelper Agent는 오픈 소스 Hermes Agent를 기반으로 만든 Nelper 전용 사내 에이전트입니다. 구성원들은 사내 Slack에서 이 에이전트를 호출할 수 있습니다. 에이전트에는 다음 정보가 연결돼 있습니다.
- Nelper 소스 코드와 문서
- Notion, GitLab
- n8n 운영 데이터
- 배포 정보와 데모 환경
저는 고객 현장에서 일하는 인포그랩 구성원들이 Nelper Agent를 잘 활용하도록 돕는 일에도 공을 들였습니다. 특히 사내 홍보와 발표에서 다음 내용을 알렸습니다.
- (실제 대화로 보여 줌) 완성된 질문이나 기획서가 없어도, Slack에서 사람과 대화하듯 기능을 묻고 워크플로 분석을 요청하거나 아이디어를 남길 수 있다는 점
- Nelper Agent가 무엇을 할 수 있는지, 어디까지 읽고 쓸 수 있는지
그 결과, 구성원들은 현장에서 일할 때, Nelper Agent에 부담 없이 질문하고 의견도 적극적으로 전달했습니다.
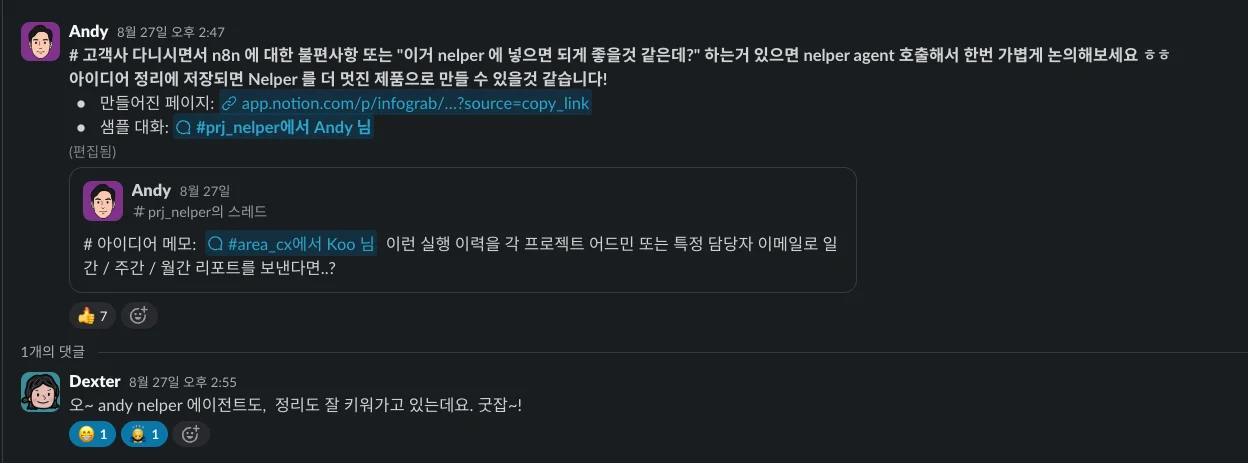
대시보드 갱신 주기를 묻는 질문과 아이디어 메모 요청이 그 예입니다.
| 요청 | Nelper Agent가 하는 일 |
|---|---|
| “대시보드는 몇 분마다 갱신되나요?” | 오래된 문서를 검색해 답하지 않고 현재 브랜치에서 갱신 옵션과 실제 refetchInterval 연결을 확인한 뒤 답합니다. |
| “이 아이디어 메모해” | 대화를 그대로 옮기지 않고 관련 수집기와 데이터 모델을 먼저 읽습니다. 그다음 재사용할 수 있는 구조와 새로 필요한 범위, 예상되는 위험 요소를 정리해 Notion에 남깁니다. |
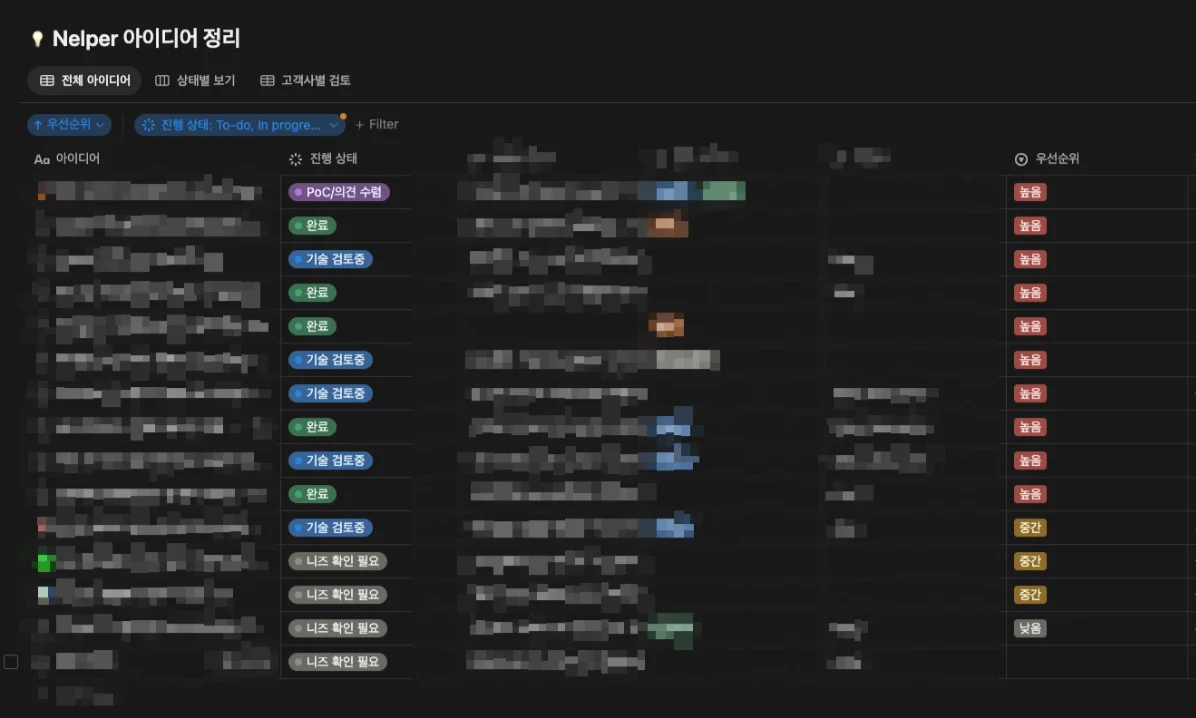
언뜻 보면 Nelper Agent가 다양한 기능을 제공하는 것으로 보이기도 합니다. 그러나 저는 에이전트에 기능을 많이 붙이는 일보다 앞단의 고객 요구사항 관련 내용과 뒷단의 저장소와 검증 환경을 같은 사이클 안에서 원활히 연결하는 일이 더 중요했습니다.
뒷단에는 AI가 바로 일할 수 있는 개발 환경을 두었습니다
앞단에서 Nelper Agent가 고객의 요구사항과 맥락을 정리하면, 뒷단에서는 로컬 AI가 관련 코드와 저장소 규칙을 바탕으로 구현을 돕습니다. 이 구간에서는 특정 AI 모델보다 개발 환경에 초점을 맞췄습니다. AI가 원활히 일하는 환경을 구축하기 위해 Nelper 저장소에 다음 내용을 코드 가까이에 정리했습니다.
- 제품 구조와 계층 간 의존 규칙
- 실행 명령과 테스트 방법
- 데이터 접근 원칙
- 배포 조건과 완료 기준
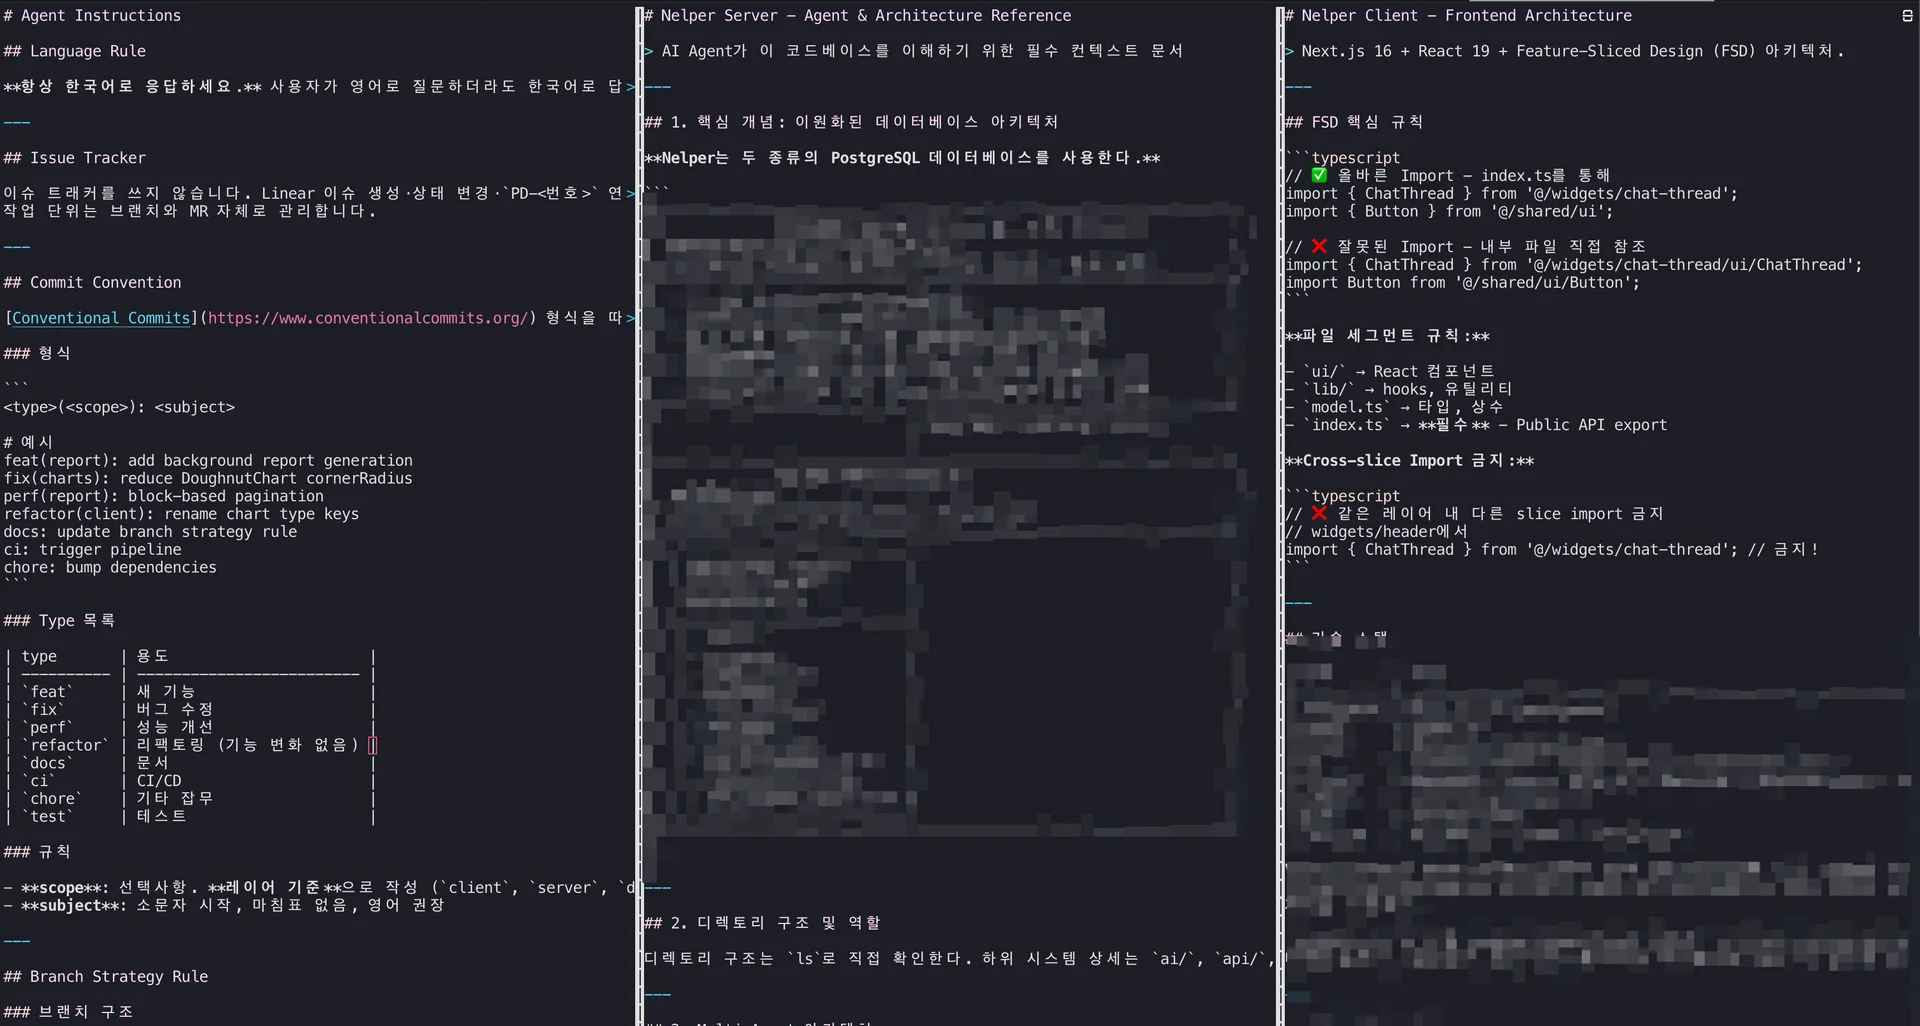
규칙을 정리해 두면, 새 작업을 시작할 때마다 프로젝트의 기술 스택과 기본 구조를 AI에게 처음부터 다시 설명하지 않아도 됩니다. 예를 들어, OpenAI의 코딩 에이전트 Codex는 저장소의 규칙과 관련 코드를 먼저 읽고 실제 호출 경로를 따라간 뒤 코드를 변경합니다.
AI를 활용한 빠른 기능 구현은 단순히 잘 작성한 프롬프트 한 줄에서 나오지 않았습니다. 에이전트가 별도의 설명 없이도 알아서 잘 움직이도록 저장소와 개발 환경에 관련 컨텍스트를 미리 심어 둬야 AI로 신속하게 개발할 수 있습니다.
검증도 구현과 같은 사이클에 넣었습니다
구현이 빨라져도, 그 기능을 사용자가 실제로 사용할 수 있는지는 따로 확인해 봐야 합니다. AI가 작성한 코드의 API 응답이 정상이라고 해서 사용자가 그 기능을 실제로 이용할 수 있는 것은 아니기 때문입니다. 이에 저는 구현 이후 검증도 개발 환경 안에 함께 포함했습니다.
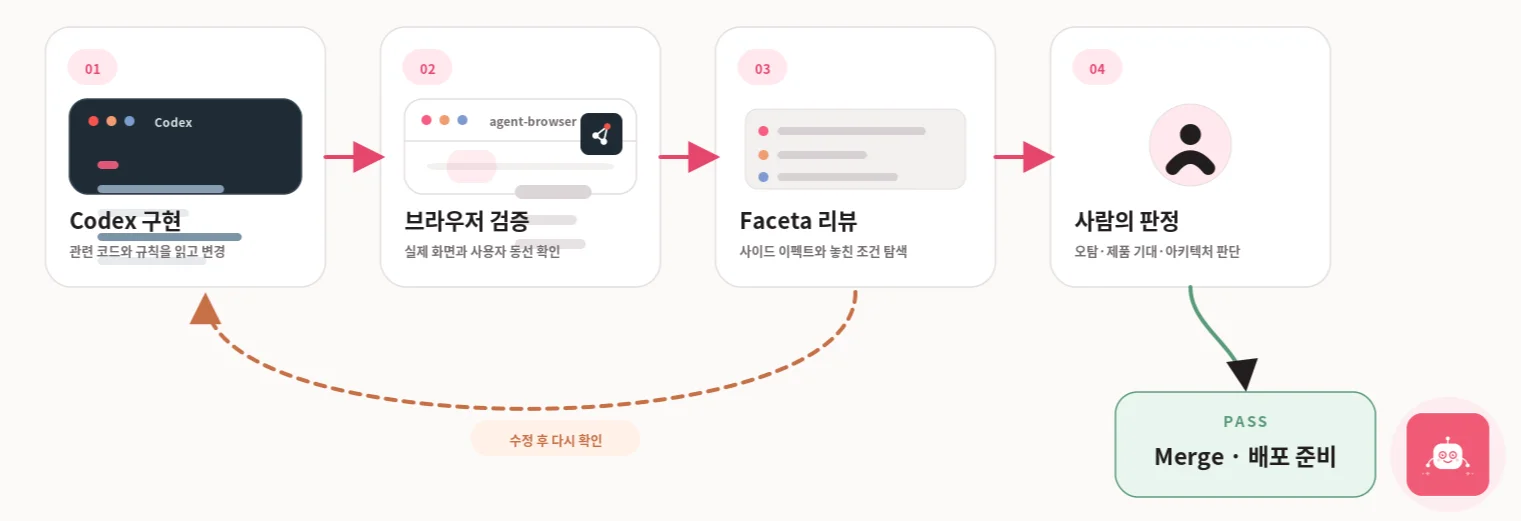
- 화면 검증: 브라우저 기반 자동화 도구로 실제 화면을 연 뒤 사용자의 동선을 따라가며 기능을 확인합니다. 필요하면 스크린샷과 네트워크 기록을 남겨 결과를 빠르게 판단합니다.
- Preview 환경: Merge Request(MR)마다 변경 사항을 확인할 수 있는 전용 Preview 환경을 만듭니다. 운영 환경에 반영하기 전에 이 환경에서 실제 사용자 동선으로 화면과 동작을 검증합니다.
- AI 코드 리뷰: MR을 올리면 다른 관점의 코드 리뷰를 추가합니다. 인포그랩의 AI 코드 리뷰 도구 Faceta가 변경으로 생길 수 있는 부작용과 놓친 점을 찾습니다. 리뷰할 때는 그 리뷰가 어느 커밋을 기준으로 생성됐는지 확인하고 해당
head SHA의 변경 내용과 리뷰 근거를 함께 살펴봅니다. - 재확인과 판단: 코드를 수정한 뒤 새 리뷰에서 문제가 해소됐는지 다시 확인합니다. 제품의 맥락을 알아야 옳고 그름을 정확히 가릴 수 있는 지적은 사람이 직접 판단합니다.
개발의 끝을 merge로 잡지 않았습니다
검증을 거쳐 코드를 merge해도 제품 개발이 끝나지는 않습니다. 변경된 내용이 현장에 전달되고 그 기능을 두고 질문과 피드백이 다시 들어와야 하나의 사이클이 끝납니다. 이에 저는 업데이트 노트와 제품 문서도 제품 개발과 별개의 작업으로 두지 않고 다음 순서로 같은 사이클에 넣었습니다.
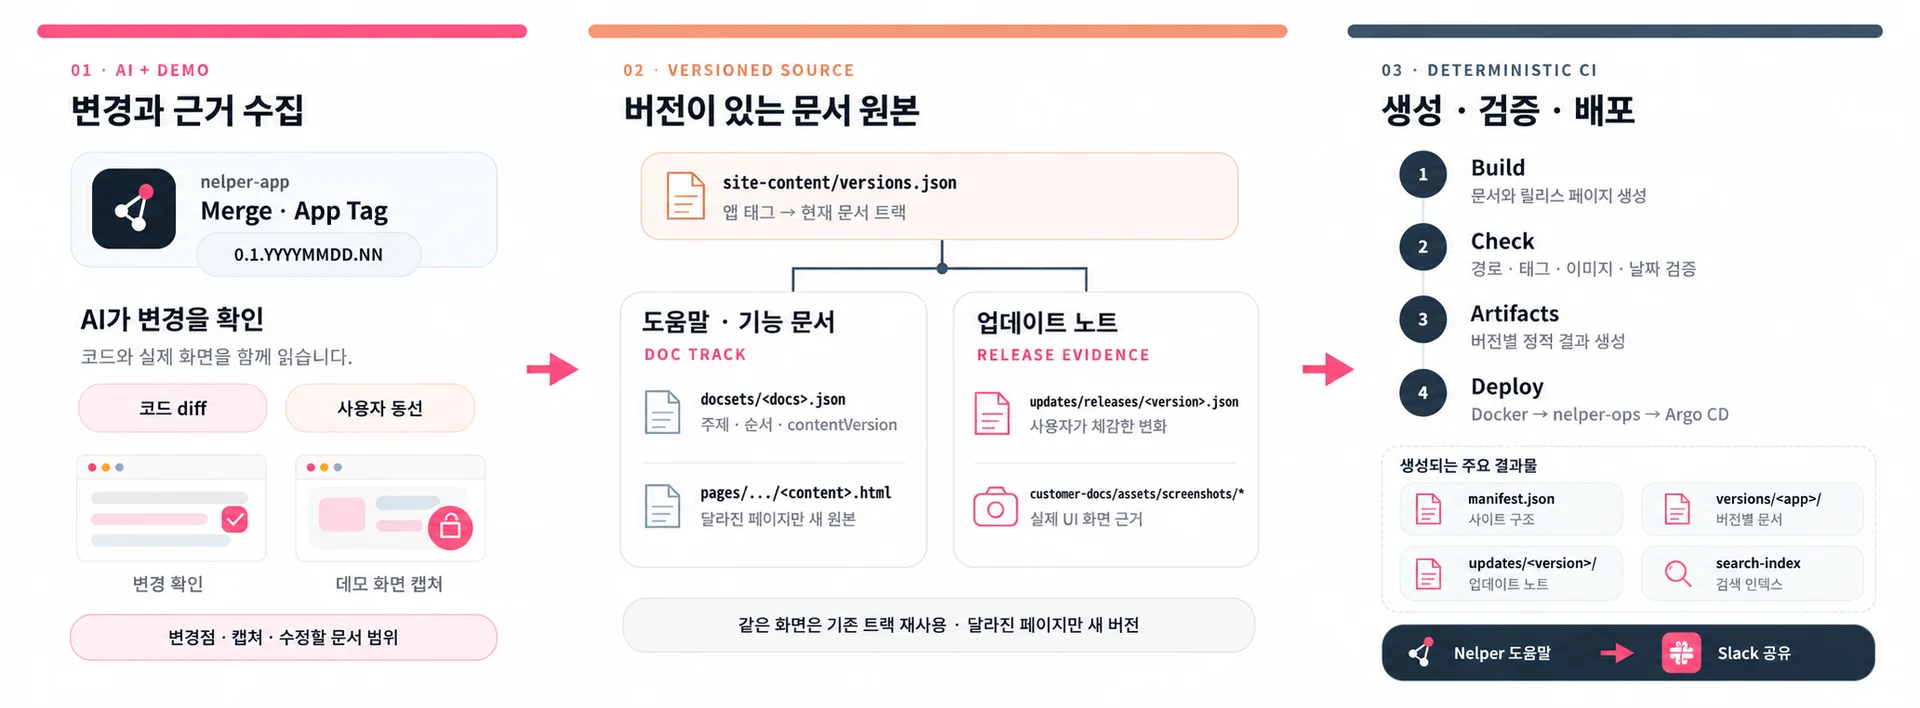
- 버전 연결: 배포 버전과 문서 버전의 연결 규칙을 저장소에 둡니다. 릴리즈 파이프라인은 새 앱 태그와 현재 문서 버전을 연결합니다.
- 문서 갱신: 새 버전이 나오면 AI가 관련 코드의 변경 사항을 확인하고 데모 환경에서 실제 UI를 열어 사용자 관점에서 무엇이 달라졌는지 살펴봅니다. 이어서 필요한 화면을 캡처해 업데이트 노트와 기능 설명서에 반영하고 관련 문서도 함께 수정합니다. 이 모든 과정은 “최신 버전에 대한 업데이트 노트와 관련 기능 문서 업데이트해 줘”라는 요청 한 문장으로 시작됩니다.
- 사내 공유: 완성된 업데이트 노트와 문서는 Nelper Agent가 사내에 공유합니다.
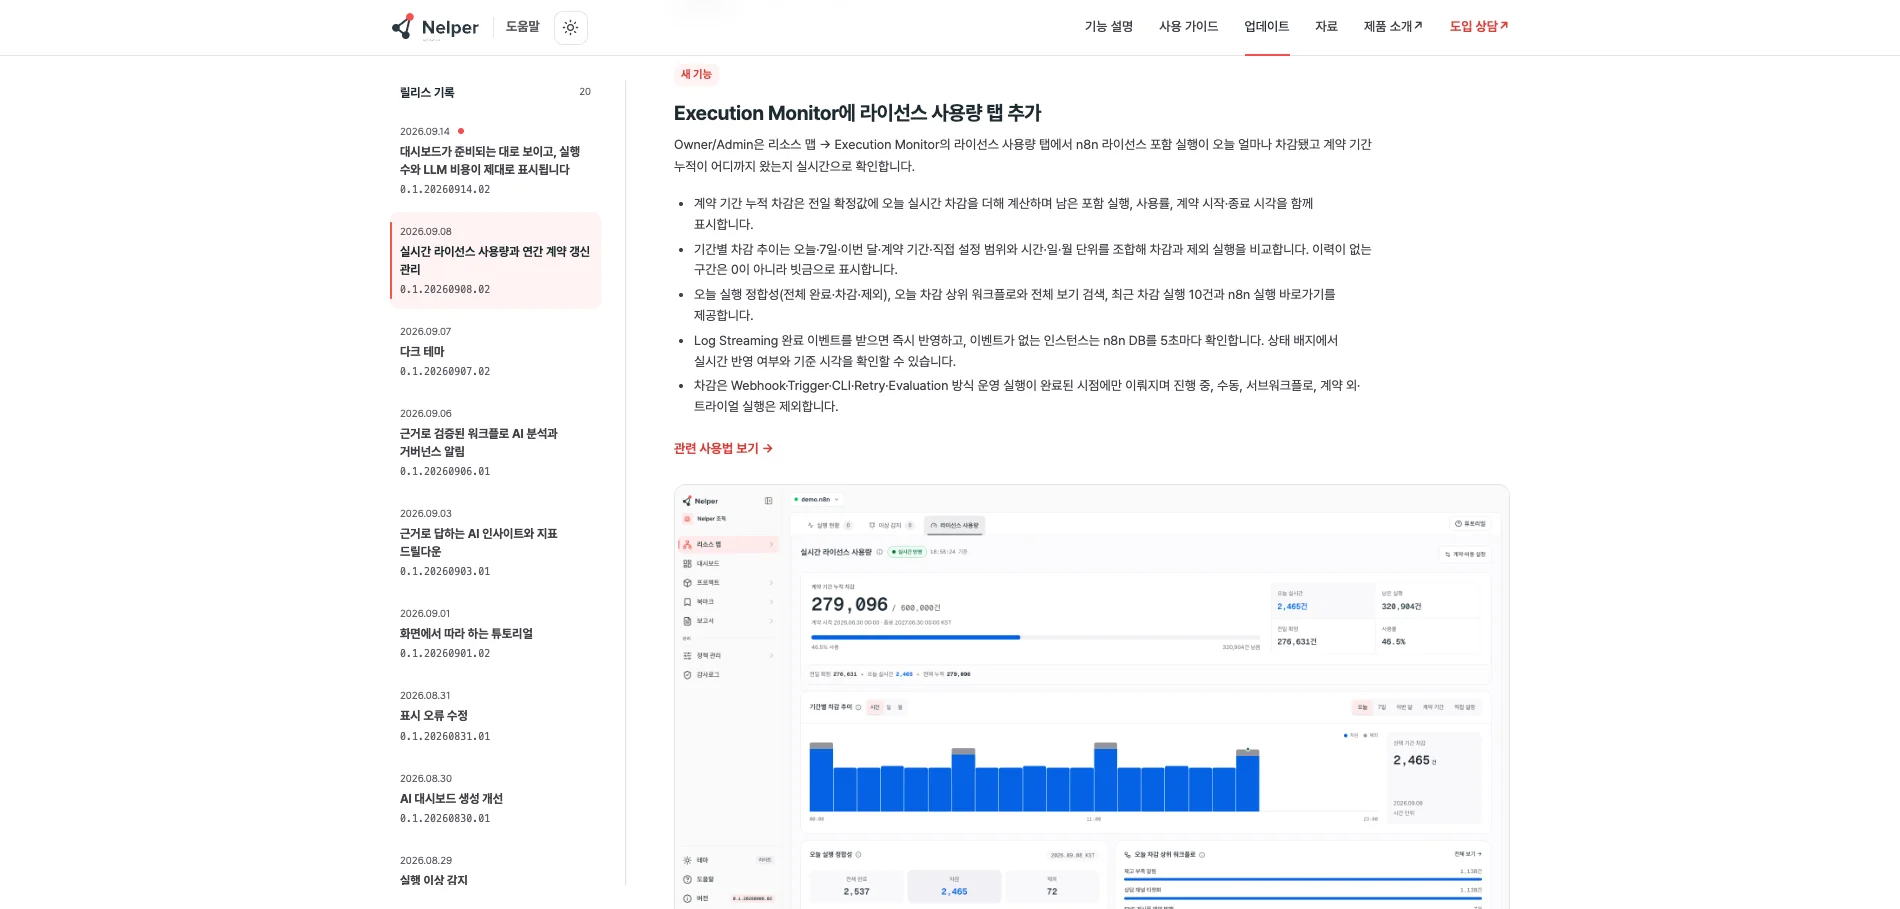
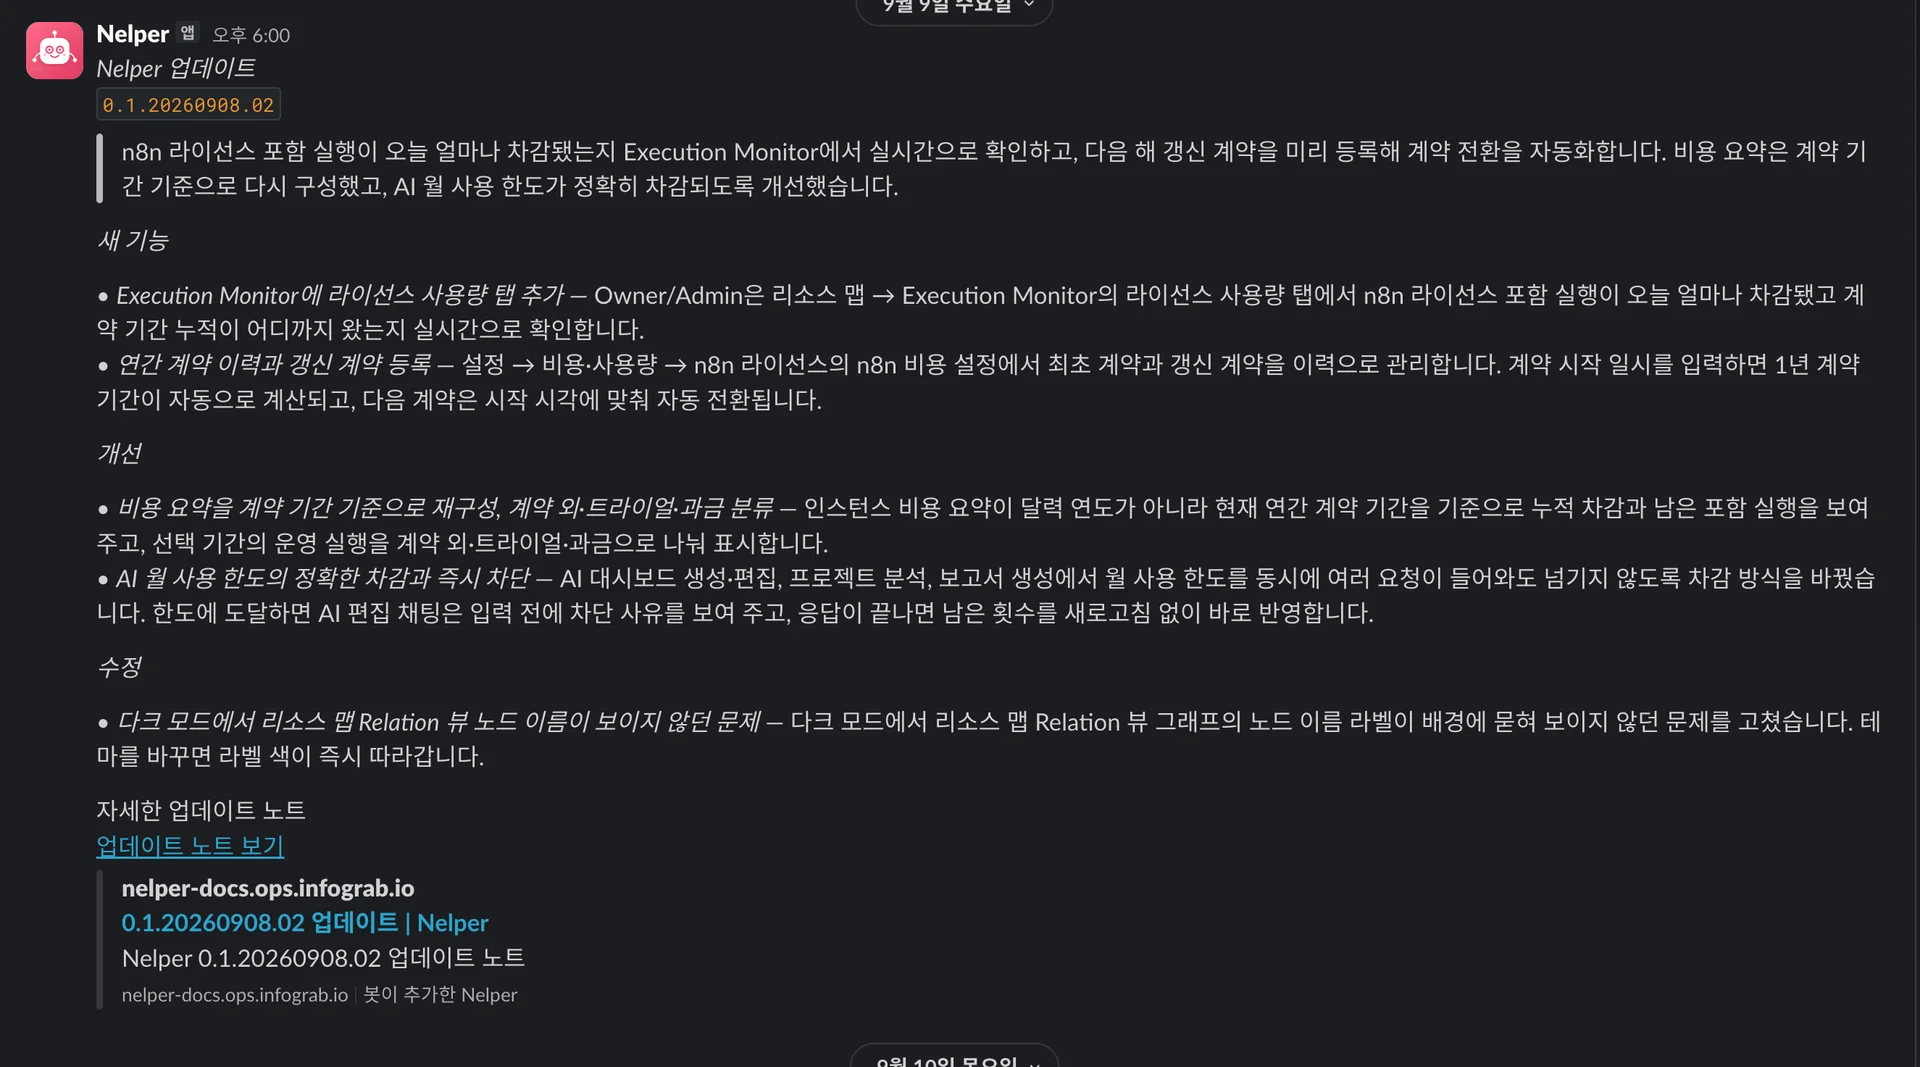
이때 공유하는 문서에 실제 화면이 함께 들어가야 사용자가 기능을 오해 없이 이해할 수 있습니다. 이를 위해 사내 중요 정보가 없는 데모용 Nelper와 n8n 환경을 늘 사용할 수 있도록 유지하고 있습니다. 에이전트는 이 환경에서 실제 사용자 동선을 따라가며 필요한 화면을 직접 확인합니다. 덕분에 캡처할 때마다 운영 데이터를 노출하지 않기 위해 별도 환경을 만드는 수고도 줄였습니다.
고객의 한마디는 어떤 과정을 거쳐 실제 기능이 됐을까요?
최근 Nelper에 추가한 n8n 라이선스 사용량 기능은 고객 요청부터 사내 공유까지 이 사이클을 거쳤습니다.
고객 요청은 1분 만에 기술 메모가 됐습니다
다음 사례는 인포그랩 DevOps 엔지니어가 고객의 요청을 Slack에 전달하면서 시작됐습니다. n8n 라이선스에서 실제로 차감되는 실행 수를 정확하게, 당일 사용량까지 실시간으로 확인하고 싶다는 요청이었습니다. 당시 Nelper는 전날까지 완료된 실행을 일 단위로 집계해 보여 주고 있었습니다. 저는 현재 제품의 동작을 확인한 뒤 이렇게 답했습니다.
“로그 스트리밍 붙여서 만들면 되는데, 개발 진행할까요?”
그 엔지니어에게서 고객 만족도가 높아질 것 같다는 답변을 받았습니다. 이에 저는 그날 오후 1시 2분에 같은 Slack 스레드에서 Nelper Agent에게 이 아이디어를 메모하도록 요청했습니다. 1분 뒤 Notion에 다음 기술 메모가 생성됐습니다.
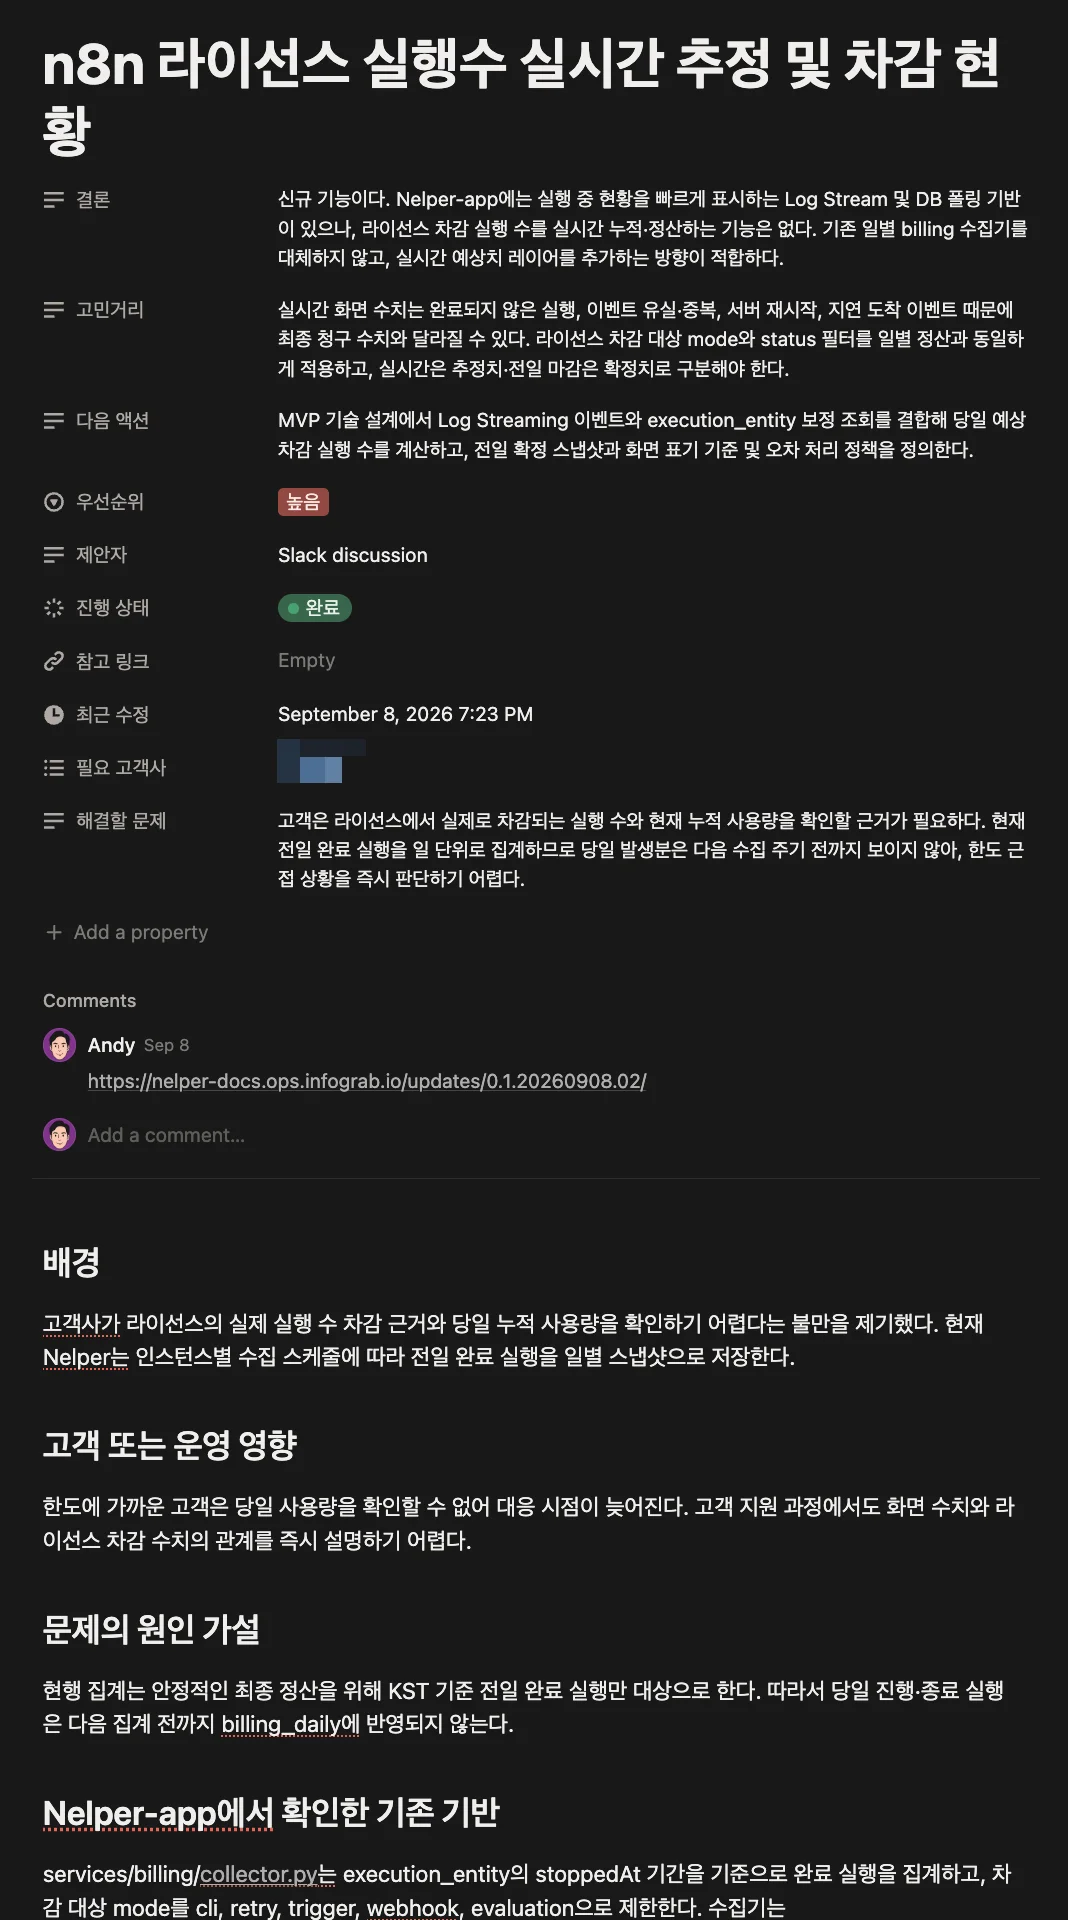
이때 Nelper Agent는 대화 내용만 요약하지 않았습니다. 일별 수집기와 실행 데이터, Log Streaming 추적기, 라이선스 설정 코드를 먼저 확인했습니다. 그다음 기존 구조에서 재사용할 수 있는 부분과 새로 필요한 범위를 정리했습니다.
구현에서는 믿을 수 있는 숫자를 만드는 데 집중했습니다
이 기술 메모를 출발점으로 로컬 AI와 함께 기능을 구현했습니다. 숫자는 전날까지 확정값과 당일 실행 수로 나눠 구했습니다.
- 전날까지 확정값: 기존 집계 데이터를 사용
- 당일 실행 수: 실행 데이터와 Log Streaming 이벤트를 함께 확인
여기에 중복 집계와 미수집 상태를 다루는 원칙을 더했습니다.
- 이벤트와 데이터베이스(DB)에 같은 실행이 함께 있으면 한 번만 셉니다.
- 데이터를 다 수집하지 못한 상황에서는 낮은 숫자나
0을 정상값처럼 보여 주지 않고 확인할 수 없는 상태임을 분명히 표시합니다.
고객에게는 빠르게 바뀌는 숫자보다 왜 그 숫자가 나왔는지 설명할 수 있는 근거가 필요했습니다. 두 원칙을 둔 이유도 여기에 있습니다.
검증부터 사내 공유까지 같은 사이클로 이어졌습니다
첫 화면은 빠르게 나왔습니다. 다만 실제 제품으로 쓸 수 있는 수준까지 다듬는 과정은 따로 필요했습니다.
- Faceta와 로컬 AI를 연결해 수정을 반복하며 완성도를 높였습니다.
- 브라우저 기반 자동화 도구로 화면을 확인하고 추가 코드 리뷰로 놓친 영향을 다시 살펴봤습니다.
- MR별 Preview 환경에서 실제 사용자 동선으로 기능을 검증했습니다.
- 배포와 업데이트 노트 작성, 사내 공지까지 같은 사이클로 이어 갔습니다.
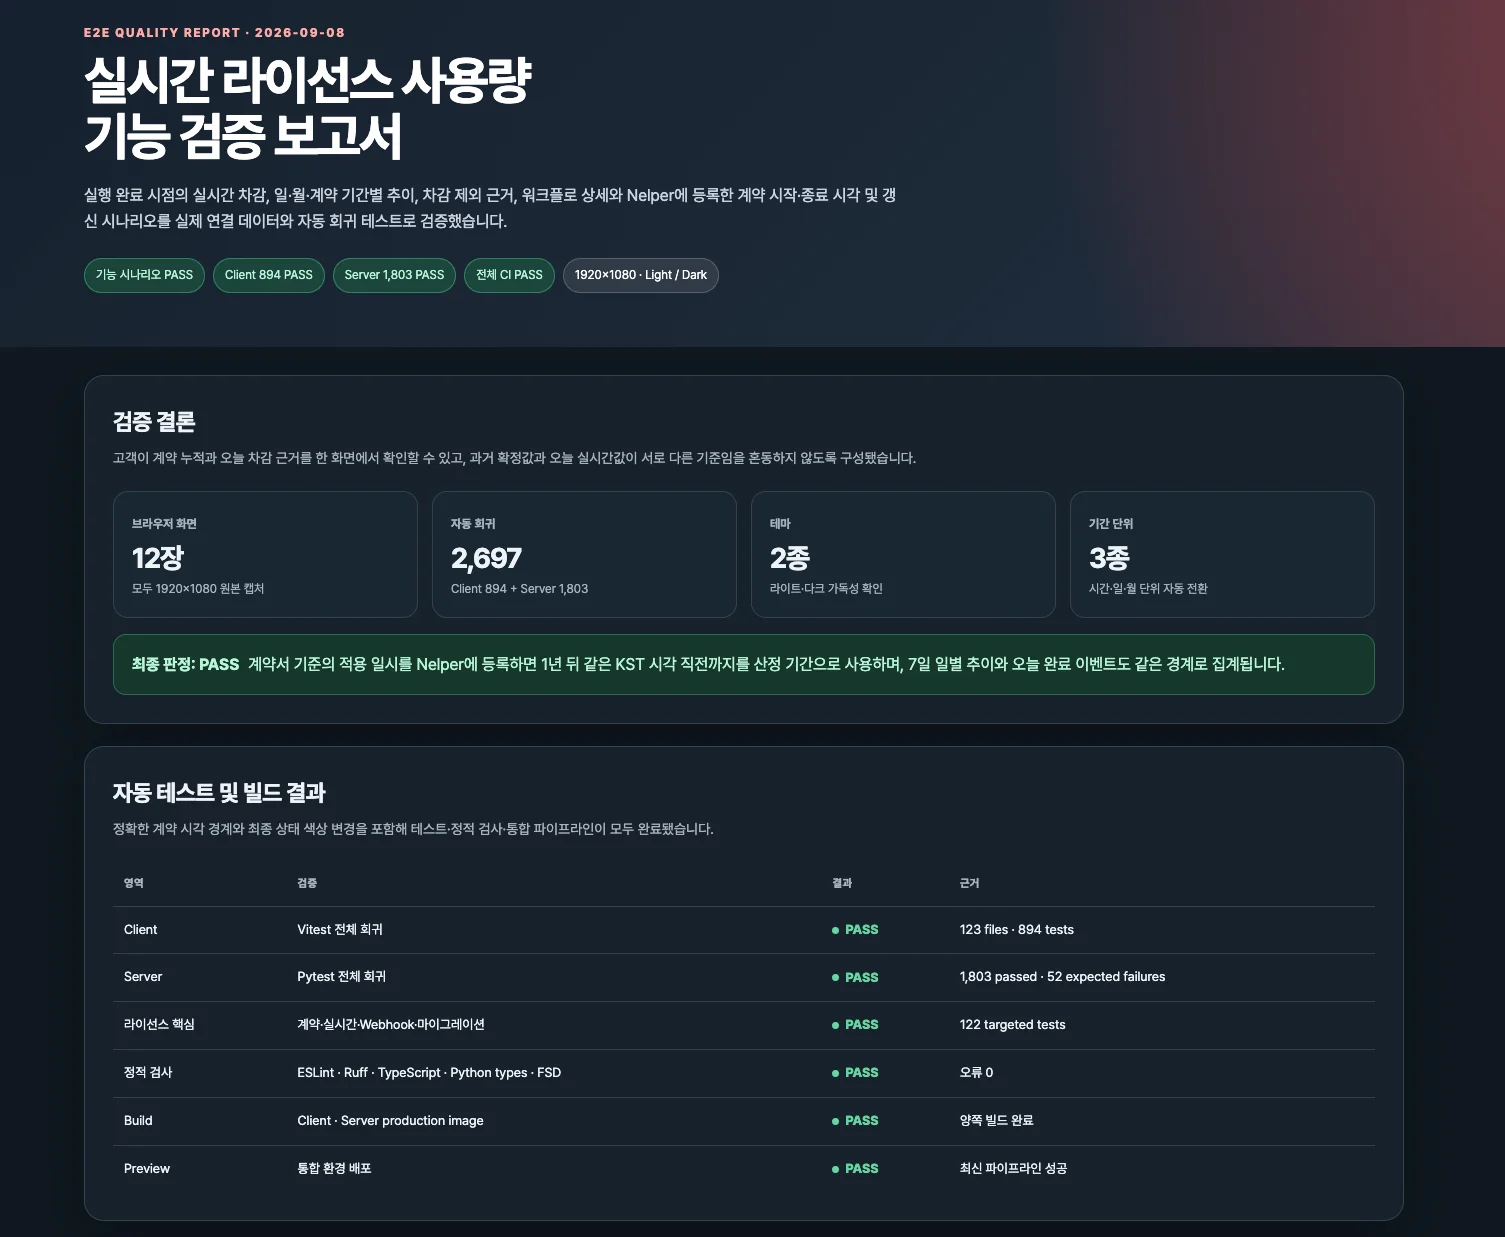
이 사례에서 중요한 점은 고객의 요구사항이 중간 전달 과정에서 맥락을 잃지 않고 온전히 보전됐다는 점입니다. 이는 우선순위 판단 단계부터 기능 구현과 검증, 배포와 공유 단계까지 단절되지 않고 공유됐습니다.
무엇을 자동화하고, 무엇을 사람이 판단할까요?
각 단계에서 반복되는 실행은 자동화할 수 있었습니다. 그러나 단계 사이의 판단까지 모두 에이전트에게 넘기지는 않았습니다.
실행은 자동화하되, 단계 사이의 판단은 사람이 맡습니다
먼저 제품 단계마다 에이전트와 자동화가 맡을 일과 사람이 판단할 일을 나눴습니다.
| 제품 단계 | 에이전트와 자동화가 줄이는 일 | 사람의 판단이 필요한 일 |
|---|---|---|
| 고객 요구사항 | Slack 맥락 복원, 현재 근거 수집, 아이디어 문서화 | 실제 문제인지, 누구의 문제인지 |
| PoC | 데모 데이터 분석, 시제품 실행, 화면과 로그 수집 | 폐기할지, 제품으로 가져갈지 |
| 개발 | 관련 코드 탐색, 구현과 테스트 초안, 반복 수정 | 아키텍처 경계와 제품 동작 |
| 검증 | 브라우저 기반 자동화 도구, 자동 테스트, AI 코드 리뷰(Faceta), MR Preview | 결과가 고객의 기대에 맞는지, 리뷰 지적을 반영할지 |
| 배포와 공유 | 이미지 빌드, 격리 환경 생성, 버전 연결, 공지 전달 | 배포 시점과 고객에게 설명할 내용 |
위 단계와 별개로, 답이 명확하게 정해지는 작업에는 에이전트를 쓰지 않을 때도 많았습니다. AI를 많이 쓰는 것 자체가 목적은 아니라서 작업의 성격에 따라 처리 방식을 나눴습니다.
- 스크립트와 크론: Git 동기화 상태, 프로세스 실행 여부, 버전 누락 여부처럼 정해진 입력으로 결과를 판별할 수 있는 작업
- 에이전트: 여러 근거를 함께 살펴보고 의미를 판단해야 하는 작업
마지막 디테일은 여전히 사람이 챙깁니다
단계 사이의 판단만큼 마지막 디테일도 사람이 끝까지 챙겨야 합니다. AI는 첫 결과물을 빠르게 만듭니다. 그러나 그 이후에 발견되는 디테일까지 AI가 발견하지 못할 때가 있고요. 실제 제품에서는 이러한 디테일이 사용자 경험과 신뢰를 결정하는 일이 많죠. n8n 라이선스 사용량 기능도 숫자를 화면에 출력하는 데서 끝냈다면 훨씬 더 빨리 만들 수 있었습니다. 그러나 다음 질문을 계속 따져 봐야 했습니다.
- 이벤트와 DB 데이터가 함께 있을 때 중복이 생기지 않는가
- 계약 갱신 시점의 경계를 어떻게 처리할 것인가
- 데이터가 비어 있을 때
0으로 오해되지 않는가 - 고객에게 “실시간”이라는 표현을 어디까지 쓸 수 있는가
이런 디테일은 제품과 시스템을 이해하는 사람이 계속 질문해야 챙길 수 있습니다. AI는 관련 근거를 빠르게 수집합니다. 그러나 어디까지가 확인된 사실인지, 무엇을 제품에 반영할지까지 AI가 사람의 시선으로 정확히 판단하고, 결정하는 데는 한계가 있습니다. 사람이 중요하다고 생각하는 점을 AI는 고려하지 않을 수도 있기 때문입니다. 이는 사람이 챙겨야 합니다.
이에 저는 반복 확인과 초안 작성, 환경 준비와 증거 수집은 최대한 자동화합니다. 그렇게 확보한 시간은 AI가 놓치기 쉬운 디테일과 새로운 PoC, 고객의 다음 질문을 챙기는 데 씁니다.
맺음말
이 사이클을 만들어 운영하면서 AI의 효과가 모델의 성능만으로 높아지지 않는다는 점을 확인했습니다. AI 코딩 도구 덕분에 과거에 며칠씩 걸리던 API 연결, 화면 구현, 테스트 초안 작성은 이제 몇 시간 안에 끝낼 수 있습니다. 그러나 고객의 요구사항, 제품 코드, 운영 데이터, 개발/검증 환경, 배포 이후 문서화가 서로 분리돼 있으면, 코드 작성 속도가 빨라져도 전체 제품 개발 속도는 크게 개선되지 않습니다.
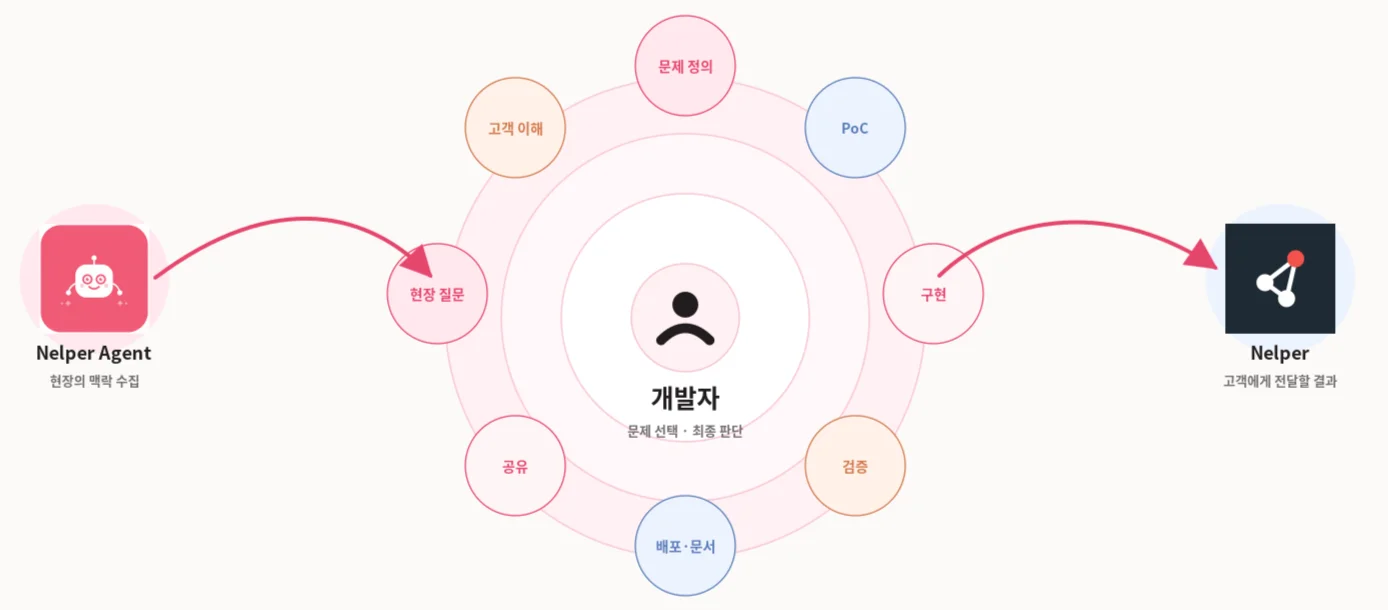
저는 속도보다 고객의 문제를 실제로 해결하고 그 결과를 신뢰할 수 있게 하는지를 좋은 제품의 기준으로 봅니다. n8n 라이선스 사용량 기능 개발 사례에서 봤듯, 고객은 믿을 수 있는 숫자를 원했습니다. 그런 숫자를 내놓으려면 고객과 나눈 대화에 담긴 맥락을 꼼꼼히 확인해야 했습니다. 현재 제품의 코드와 운영 데이터, 기존 설계의 이유와 제약 사항의 근거도 함께 봐야 했죠. 개발 과정에서 고객 요구사항의 맥락을 잃지 않고 참고하는 환경이 필요한 이유입니다.
이 환경에서도 반복 가능한 실행은 에이전트와 자동화에 맡겼습니다. 대신 문제의 우선순위와 제품의 경계를 정하고 결과를 판단하는 일은 사람이 담당했습니다. 기술 아키텍처와 기본기는 이 과정에서 오히려 더 중요해집니다. AI가 빠르게 만든 결과가 맞는지 판단하려면 결국 사람이 제품과 시스템을 먼저 이해하고 있어야 하기 때문입니다.
결국 AI 시대의 개발 생산성은 ‘코드를 얼마나 빨리 작성하는가’보다 ‘고객 요구사항의 맥락을 얼마나 생생한 상태로 신속하게 실행까지 연결하는가’에 달려 있습니다. AI를 제품 개발에 활용할 때는 프롬프트보다 AI가 잘 일할 수 있는 환경을 조성하는 게 중요할 수 있습니다. 이는 사람이 고객의 문제와 제품의 디테일에 더 집중해 개발 품질을 높이는 데 도움이 될 것입니다.
n8n 운영 현황, 지금 한눈에 보이나요
Nelper는 여러 n8n 인스턴스의 워크플로와 실행 이력, 오류, 비용, 라이선스 사용량을 한곳에서 확인하고 분석하게 해 줍니다. 지금 쓰는 n8n 환경부터 진단받으세요.
참고 자료
- “Nelper: n8n Operations Platform”, 인포그랩, https://nelper.infograb.io/
- “hermes-agent”, GitHub, https://github.com/NousResearch/hermes-agent
- “AGENTS.md”, Agentic AI Foundation, https://agents.md/
- “Faceta: 폐쇄망 GitLab을 위한 코드리뷰 게이트”, 인포그랩, https://faceta.io/
- “Stream logs to external systems”, n8n Docs, https://docs.n8n.io/administer/observe-and-log/stream-logs-to-external-systems
관련 글 더 읽기
- Chad(임희호), “k6로 n8n 부하테스트 - worker를 8배 늘려도 처리량이 그대로인 이유”, 인포그랩, 2026-08-26, https://insight.infograb.net/blog/2026/08/26/k6-n8n-load-test/
- Grace(박민영), "n8n 워크플로 관리: 워크플로는 남는데 소유권은 왜 사라질까", 인포그랩, 2026-07-15, https://insight.infograb.net/blog/2026/07/15/n8n-visibility/
- Miles(송민기), "LLM·하네스로 더 좋은 n8n 워크플로 생성하기", 인포그랩, 2026-06-17, https://insight.infograb.net/blog/2026/06/17/n8n-harness/
- Andy(윤영진), "n8n 기반 DevOps·AI 콘텐츠 자동 수집·요약 실전 가이드", 인포그랩, 2025-12-17, https://insight.infograb.net/blog/2025/12/17/n8n-devops-contents/
- Fabbro(박용석), "n8n과 GitLab으로 개발팀 스탠드업 자동화하기", 인포그랩, 2025-05-14, https://insight.infograb.net/blog/2025/05/14/n8n-gitlab-standup/

Andy
Software Engineer
Software Engineer로서 Full Stack 개발부터 배포까지 담당하며, n8n 기반 업무 자동화도 구축·운영합니다. 문제의 원인을 빠르게 분석해 해결책을 도출하는 것을 즐기고, 자동화를 통해 사용자의 리소스를 절감하는 데 관심이 많습니다.
이 저자의 글 모두 보기 →이 글이 도움이 되셨나요?
인포그랩 전문가가 맞춤 상담을 도와드립니다.
관련 글
n8n 워크플로 관리: 워크플로는 남는데 소유권은 왜 사라질까
n8n 워크플로가 100개를 넘으면 누가 만들었고 무엇에 물려 있는지부터 흐려집니다. n8n 기본 기능으로 소유권·구조를 어디까지 볼 수 있는지, 그 빈자리를 인포그랩 Nelper는 어떻게 채우는지 정리했습니다.
k6로 n8n 부하테스트 - worker를 8배 늘려도 처리량이 그대로인 이유
n8n Queue Mode에서 worker를 늘려도 처리량이 오르지 않는 이유를 k6와 Grafana로 측정했습니다. 슬롯 점유율 100%인데 CPU는 한 자릿수였던 원인은 task runner 한도였고, 러너 한도만 바꿔 처리량이 7.2배 차이 났습니다.
LLM·하네스로 더 좋은 n8n 워크플로 생성하기
LLM에 정확한 정보와 도구를 제대로 쥐여 주면 더 높은 품질의 n8n 워크플로를 생성할 수 있습니다. 이 글은 LLM의 작업 환경 전체를 설계하는 접근 방식인 '하네스(Harness)'를 만들어 실험한 내용을 다뤘습니다. 같은 모델과 같은 요청을 두고 하네스 수준만 바꿨을 때 모델이 생성한 n8n 워크플로 품질이 어떻게 달라지는지 소개합니다.