

루프를 품은 그래프 엔지니어링: Claude Code와 OmO로 본 설계와 실행
"이 PR 리뷰하고, 문제 있으면 고쳐 줘." 코딩 에이전트에게 PR(Pull Request) 리뷰와 수정을 맡길 때 요청은 이 한 줄이면 되지만, 에이전트가 할 일은 여러 단계로 나뉩니다. 이를테면 PR의 코드 변경을 정확성, 보안, 성능 측면에서 각각 검토하고요. 이때 찾은 문제가 진짜 문제인지 다시 확인합니다. 실제로 문제가 확인되면 이를 고치고요. 수정한 코드가 테스트를 통과할 때까지 수정과 테스트를 반복하죠.
이 네 단계의 작업을 에이전트 하나에만 전부 맡기면 어떤 일이 벌어질까요? 첫째, 절차를 프롬프트나 스킬 같은 지시로만 전달하면 어떤 단계를 언제 어떻게 거칠지 에이전트가 그때그때 스스로 판단합니다. 그래서 훅 같은 별도 장치를 걸어 두지 않는 한 특정 단계를 빠뜨리지 않도록 강제하기 어렵고요. 검증 같은 단계를 건너뛸 수도 있죠. 둘째, 하나의 에이전트가 여러 측면을 한 번에 검토하다 보니 각 측면을 꼼꼼히 살피기 어려워 문제를 놓칠 수 있습니다. 또 자기가 찾은 문제를 자기가 다시 검증하니 처음 판단에 기대어 실제로는 문제가 아닌 것까지 고쳐야 할 문제로 잘못 넘길 수도 있죠. 셋째, 각 단계의 결과와 에이전트의 판단이 한 대화 안에 뒤섞여 남아 에이전트가 중간에 어느 단계를 건너뛰었는지, 어디서 판단이 어긋났는지 정확히 추적하기가 어려울 수 있습니다.
이처럼 에이전트 하나에 여러 단계의 작업을 맡길 때 생기는 문제를 풀 실마리로 최근 '그래프 엔지니어링(Graph Engineering)'이라는 개념이 주목받고 있습니다. 이 글에서 말하는 그래프 엔지니어링은 여러 단계로 이뤄진 작업을 에이전트 여럿에게 각각 나눠 맡기고, 어떤 작업을 동시에 실행할지, 다음 단계에 어떤 정보를 넘길지, 에이전트가 낸 결과를 어떻게 검증할지, 전체 작업을 언제 끝낼지에 관한 규칙을 작업을 시작하기 전에 그래프로 명시해 두는 설계 방법인데요. 여기서 그래프는 에이전트를 점으로, 에이전트 사이의 실행 순서를 선으로 나타낸 작업 흐름도입니다.
앞서 살펴본 코딩 에이전트의 PR 리뷰를 예로 들면, 리뷰 에이전트 셋이 세 가지 리뷰 측면(정확성, 보안, 성능)을 하나씩 맡아 코드 변경을 다각도로 검토하고요. 이들이 찾은 문제는 파일과 줄, 근거와 함께 별도의 검증 에이전트로 넘어가 실제 문제인지 확인받습니다. 다음에 어느 단계를 실행할지는 미리 정한 그래프가 결정하므로 그래프에 넣어 둔 검증 단계를 에이전트가 그때그때 판단해 건너뛰는 일은 없죠. 또 에이전트마다 받은 지시와 에이전트가 출력한 결과, 에이전트의 판정이 따로 기록돼 어느 에이전트에서 판단이 어긋났는지 기록을 따라가며 확인할 수 있습니다.
이 글에서는 그래프 엔지니어링의 개념을 정리하고, 그래프를 실행하는 기능을 갖춘 코딩 에이전트 Claude Code와 OmO(oh-my-openagent)를 비교합니다. 이어서 두 도구가 같은 리뷰 그래프를 각각 어떤 구조로 표현하는지 살펴보고, 설계 항목별로 두 방식의 장단점을 짚어 보겠습니다. 마지막으로 버그를 심어 둔 동일한 PR에 같은 구조의 리뷰 그래프를 두 도구로 각각 구현하고 실행한 다음, 두 방식이 실제 실행에서 어떻게 다르게 동작하는지 확인하겠습니다.
그래프 엔지니어링이란 무엇이고, 왜 필요한가요?
그래프 엔지니어링은 2026년 7월부터 널리 쓰이기 시작한 신조어입니다. 이 용어의 정의와 그래프의 구성 요소를 먼저 짚고, 루프 하나로 일할 때와 비교해 그래프가 왜 필요한지 살펴보겠습니다.
여러 에이전트 루프를 하나로 엮는 설계, 그래프 엔지니어링
그래프 엔지니어링의 두 가지 정의와 용어가 확산된 과정, 그래프를 이루는 요소를 차례로 알아보겠습니다.
Bouchard와 LangChain의 정의
그래프 엔지니어링은 아직 합의된 정의가 없어 사람과 기관마다 개념을 조금씩 다르게 정의합니다.
- Louis-François Bouchard(Towards AI 공동 창업자 겸 CTO): 동시 실행, 검증, 인계, 종료 조건을 갖춘 하나의 시스템으로 여러 에이전트 루프를 엮는 일
- LangChain(LangGraph 개발사): 에이전트 시스템을 그래프로 표현해 에이전트가 따라갈 경로를 미리 좁혀 두는 접근 전반
이 글은 Bouchard의 정의를 따릅니다. Bouchard가 예로 든 PR 리뷰 그래프가 이 글에서 실습한 그래프와 단계 구성(리뷰, 검증, 수정, 테스트)이 같기 때문입니다.
X의 농담으로 확산된 용어
그래프 엔지니어링이라는 용어는 2026년 7월 18일 OpenClaw 개발자 Peter Steinberger가 X에 올린 다음 질문을 계기로 확산되기 시작했습니다.
“Are we still talking loops or did we shift to graphs yet?”
(아직도 루프 얘기 중인가요, 아니면 벌써 그래프로 넘어갔나요?)
같은 날 AI 평가(evals) 전문가 Hamel Husain은 '루프 엔지니어링은 끝났다. 이제 그래프 엔지니어링이다(Loop Engineering Is Dead. Enter Graph Engineering)'라는 제목의 글로 화답했습니다. 프롬프트 엔지니어링이 컨텍스트 엔지니어링, 하네스 엔지니어링, 루프 엔지니어링으로 이름만 바뀌어 온 지 약 1년 만에 또 새 이름이 나왔다는 농담이었는데요. 이후에도 그래프 엔지니어링을 하나의 설계 주제로 다루는 글이 IT 업계에 잇따라 나왔습니다.
그래프 구성 요소: 노드와 선, 그리고 순환
그래프 엔지니어링의 핵심인 그래프는 다음 요소로 이뤄집니다.
- 노드(node): 작업을 맡는 단위입니다. 이 글의 실습 그래프에서 노드는 에이전트 하나를 의미합니다.
- 선(edge): 노드 사이의 실행 순서를 나타냅니다. 앞 노드의 결과에 따라 다음 노드가 갈라지기도 합니다.
작업 그래프는 흔히 순환이 없는 DAG(Directed Acyclic Graph)로 그립니다. 그러나 에이전트 그래프에는 실패하면 앞 단계로 되돌아가는 순환이 포함되기도 합니다.
루프 하나로 부족할 때 필요한 그래프
단계가 많은 작업에서는 루프 하나로 부족할 때가 있습니다. 지금부터 루프의 한계를 짚고, 그래프가 이를 어떻게 보완하는지, 그래프로 설계할 때 실행 전에 정할 항목은 무엇인지 차례로 살펴보겠습니다.
완료 조건 하나를 향해 도는 루프
루프는 에이전트가 목표를 향해 작업하고, 외부 검증 장치가 결과를 확인하고, 실패하면 다시 작업하다가 종료 조건을 만나면 끝나는 구조입니다. Claude Code의 /goal처럼 완료 조건 하나를 향해 도는 루프는 테스트 통과처럼 기준이 분명한 일에 잘 맞습니다.
그러나 작업이 여러 단계에 걸쳐 복잡해지면 루프 하나만으로 대응하기가 어려운데요. 이 글 도입부에서 살펴본 PR 리뷰 사례처럼 여러 관점의 검토와 검증, 수정을 정해진 순서로 거쳐야 하는 일을 루프 하나에 담으면, 각 단계를 어떤 순서로 거칠지를 다시 에이전트의 판단에 맡기게 됩니다. 절차를 프롬프트나 스킬 같은 지시로만 전달하면 에이전트의 순간순간 판단에 따라 특정 단계를 빠뜨릴 가능성도 있죠.
루프의 한계를 보완하는 그래프
그렇다면 그래프는 이 한계를 어떻게 보완할까요? Bouchard가 제시한 PR 리뷰 그래프를 예로 살펴보겠습니다.
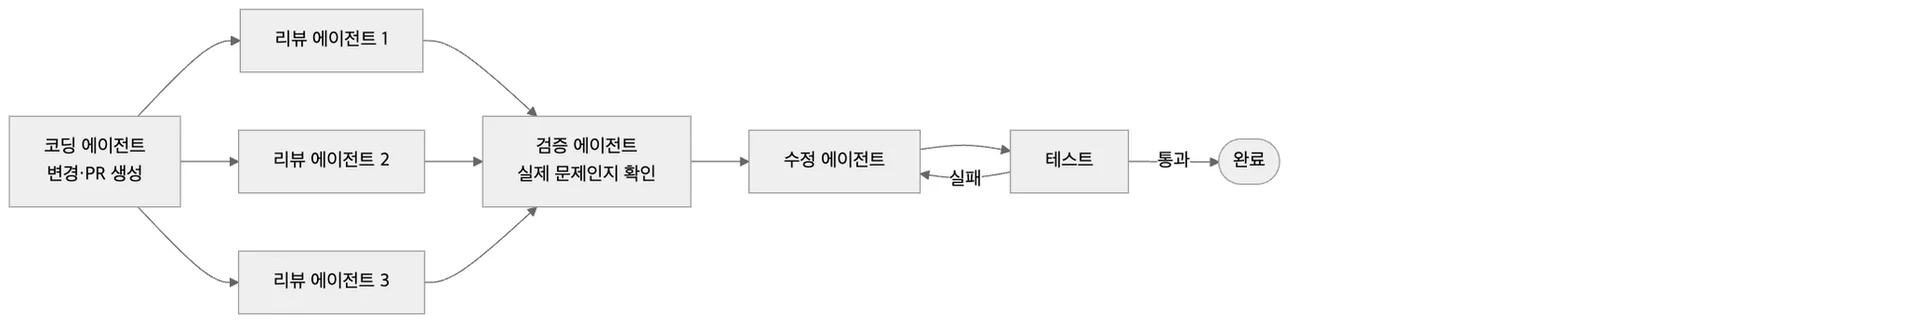
이 그래프에서는 여러 리뷰 에이전트가 PR을 동시에 검토하고, 이들이 찾은 문제가 검증 에이전트에 모입니다. 검증을 통과한 문제만 수정 에이전트로 넘어가고, 수정한 코드는 테스트를 거치며, 테스트가 실패하면 다시 수정 단계로 돌아갑니다. 다음에 어느 단계로 갈지를 에이전트가 아니라 그래프가 정하므로 에이전트가 판단해 검증을 건너뛸 수 없습니다. 또 문제를 찾는 에이전트와 검증하는 에이전트가 나뉘어 있어 자기가 찾은 문제를 자기가 검증하는 일도 없습니다.
위 그림에서 '수정 → 테스트 → 수정' 구간은 완료 조건을 충족할 때까지 작업을 이어 가는 Claude Code의 /goal과 같은 루프입니다. 리뷰·검증·수정 에이전트도 각자 작업과 확인을 되풀이하는 루프로 돌 수 있죠. 이처럼 그래프는 루프를 버리지 않고, 여러 루프를 하나로 엮는 상위 구조 역할을 합니다.
그래프 설계 시 실행 전에 정할 6가지
Bouchard가 짚었듯 그래프 구조 자체는 새로운 개념이 아닌데요. Apache Airflow 같은 워크플로 엔진은 10년 넘게 작업 그래프를 다뤄 왔고요. Anthropic이 2024년 12월 「Building Effective Agents」에서 정리한 워크플로 패턴 5가지도 그림으로 그리면 모두 그래프입니다. 달라진 것은 노드를 채우는 주체입니다. 정해진 규칙을 그대로 실행하거나 LLM을 한 번 호출하던 노드 자리에, 지시를 해석하고 스스로 판단하며 작업을 되풀이하는 에이전트가 들어갔습니다. 단, 에이전트가 때로는 지시를 잘못 이해하거나, 실행될 때마다 지시를 다르게 판단할 수 있죠.
따라서 뒤의 실습에서 다룰 PR 리뷰 그래프에서는 Bouchard가 그래프를 그릴 때 정해야 한다고 꼽은 병렬 실행, 상태 전달, 기각 권한, 비용, 종료 조건에 실패 처리를 더해 다음 6가지 항목을 실행 전에 정했습니다. 에이전트가 잘못 판단하더라도 미리 정한 경로와 한도를 벗어나지 않게 하기 위해서입니다.
| 설계 항목 | 정해야 할 내용 | 이 글의 PR 리뷰 그래프(뒤의 실습에서 구현) |
|---|---|---|
| 병렬 실행 | 무엇을 동시에 실행할까? | 정확성·보안·성능 리뷰는 동시에, 수정은 하나씩 |
| 상태 전달 | 다음 단계로 무엇을 넘길까? | 문제의 파일·줄·근거, 직전 테스트 실패 로그 |
| 기각 권한 | 누가 결과를 기각할 수 있을까? | 검증 에이전트가 리뷰 결과를 기각 |
| 실패 처리 | 실패하면 어느 단계로 돌아갈까? | 테스트 실패 시 수정 단계로 |
| 비용·반복 제한 | 어디서 비용과 반복 횟수를 제한할까? | 수정-테스트 최대 3회 |
| 종료 조건 | 언제 전체 작업을 끝낼까? | 테스트 통과 또는 반복 상한 도달 |
Claude Code와 OmO는 같은 PR 리뷰 그래프를 어떻게 표현할까요?
앞에서 6가지 설계 항목으로 정리한 PR 리뷰 그래프를 Claude Code와 OmO로 각각 만들면 어떤 모양이 될지 살펴보겠습니다. Claude Code는 Anthropic이, OmO(oh-my-openagent)는 한국 개발자가 만든 코딩 에이전트입니다. Claude Code에서는 동적 워크플로(Dynamic Workflows)가, OmO에서는 workflow 도구로 실행하는 DAG(이하 OmO 워크플로 DAG)가 그래프를 실행합니다. 두 도구 모두 노드는 에이전트 하나를 뜻하고, 노드를 잇는 선은 실행 순서를 나타내는데요. 다른 점은 그 선과 조건을 어디에 적느냐입니다.
스크립트 하나에 그래프 전체를 담는 Claude Code 동적 워크플로
Claude Code 동적 워크플로는 Claude가 작성한 JavaScript 스크립트로 여러 서브에이전트를 한꺼번에 조율하는 기능입니다. 2026년 5월 28일 리서치 프리뷰로 공개되었습니다. 사용자가 "이 PR을 정확성, 보안, 성능 세 가지로 나눠 리뷰하고, 찾은 문제를 검증한 뒤 고치는 작업을 워크플로로 처리해 줘"처럼 워크플로를 쓰라고 요청하면, Claude가 그 일을 처리할 스크립트를 직접 작성하죠. 이 스크립트 하나가 곧 그래프 전체가 됩니다.
노드는 agent() 호출, 선은 await와 parallel()·pipeline()
스크립트에서 노드는 서브에이전트를 하나 띄우는 agent() 호출을 뜻합니다. 노드를 차례로 이을 때는 앞 agent() 호출을 await로 기다린 뒤 다음 agent()를 부르면 됩니다. 여러 노드를 한꺼번에 이을 때는 다음 두 함수를 씁니다.
parallel(): 여러 노드를 동시에 실행하고 전부 끝날 때까지 기다립니다.pipeline(): 목록에 든 항목마다 여러 단계를 차례로 실행합니다.parallel()과 달리 한 항목이 다음 단계로 넘어갈 때 다른 항목이 앞 단계를 마치기를 기다리지 않습니다.
PR 리뷰 그래프를 예로 들면 정확성·보안·성능 세 가지 리뷰를 pipeline()의 항목으로 넣고, 1단계를 리뷰, 2단계를 그 리뷰가 찾은 문제의 검증으로 설계하는 식입니다. 그러면 성능 리뷰가 먼저 끝났을 때 다른 리뷰가 아직 진행 중이더라도 성능 문제 검증을 바로 시작할 수 있습니다.
조건·반복과 상태 전달은 평범한 JavaScript로
"테스트가 실패하면 코드를 다시 고친다" 같은 조건과 반복을 처리하는 특별한 문법은 따로 없습니다. 스크립트 자체가 평범한 JavaScript이므로 if와 while을 그대로 쓰면 되죠. 단, 스크립트는 파일을 읽거나 명령을 직접 실행하지 못합니다. 테스트 실행은 에이전트 노드가 맡고, 스크립트는 그 결과를 보고 반복할지 정합니다. 노드 사이에 넘기는 데이터는 스크립트 변수에 담고, 노드의 답을 정해진 JSON 형식으로 받도록 강제할 수도 있습니다.
같은 세션에서 이어 가는 실행과 실행 기록
런타임은 이 스크립트를 백그라운드에서 실행하며, 중간에 끊기더라도 같은 세션에서 이어 갈 수 있습니다. 이어서 실행하면 런타임은 이미 완료한 노드의 결과를 저장된 그대로 재사용합니다. 반면 실패한 노드는 다시 실행하고, 그 노드보다 늦게 시작한 노드도 이미 완료했더라도 모두 다시 실행합니다. 스크립트를 고쳐 프롬프트가 달라진 노드가 생기면, 처음으로 달라진 노드와 그보다 늦게 시작한 노드도 이미 완료했더라도 모두 다시 실행합니다. 실행 기록도 남습니다. 실행마다 스크립트가 ~/.claude/projects/ 아래 세션 디렉터리에 파일로 저장되고, /workflows 화면에서는 노드별 프롬프트와 최근 도구 호출, 결과, 토큰 사용량을 볼 수 있습니다. 실행한 스크립트가 마음에 든다면 저장해 두고 /이름 명령어로 다시 실행할 수 있습니다.
노드 목록과 eval 셀로 그래프를 나눠 담는 OmO 워크플로 DAG
OmO는 김연규(GitHub ID code-yeongyu)가 만든 에이전트 하네스입니다. 여기서 하네스란 LLM에 도구와 권한을 연결하고 작업 흐름을 관리해 코딩 에이전트로 동작하게 하는 프로그램을 뜻하는데요. Claude Code가 Anthropic에서 Claude 모델용으로 만든 하네스라면, OmO는 여러 회사의 모델을 한 세션에서 섞어 쓸 수 있다는 특징이 있습니다.
OmO는 처음에는 OpenCode의 플러그인(oh-my-opencode)으로 시작했고, 2026년 하반기에는 Senpi 엔진으로 단독 실행되는 OmO Native 에디션도 나왔습니다. OmO Native는 터미널에서 omo로 실행하는 독립 CLI입니다. 2026년 10월 기준으로 GitHub 스타 약 7만 개를 기록하고 있고, 소스 코드는 공개돼 있지만 OSI 기준의 오픈 소스 라이선스가 아닌 SUL(Sustainable Use License)을 따릅니다.
OmO 워크플로 DAG는 노드와 의존 관계를 적은 정의에 따라 workflow 도구가 하위 에이전트를 의존 순서대로 실행하는 기능입니다. 2026년 8월 17일 베타로 공개되었습니다.
노드 목록 run과 dependsOn으로 잇는 선
OmO 워크플로 DAG에서는 스크립트 대신 run이라는 정의를 사용합니다. run은 일종의 노드 목록으로, 노드마다 ID, 할 일(프롬프트), 어떤 모델로 돌릴지(카테고리), 먼저 완료돼야 하는 노드(dependsOn)를 적어 둡니다. 노드 하나는 다음과 같은 형태를 띱니다.
{ "id": "verify", "category": "quick",
  "prompt": "Verify each finding in /tmp/audit.md against src/.",
  "dependsOn": ["audit"] }
실행 엔진은 dependsOn에 적은 앞 노드가 모두 완료되면 다음 노드를 바로 실행합니다. 한 노드가 완료되면 그 노드를 기다리던 다음 노드가 곧바로 시작되는 식이죠. 노드마다 지정하는 카테고리는 모델과 허용 도구를 묶어 둔 설정입니다. 그래서 노드별로 다른 회사의 모델을 쓸 수 있습니다. 프롬프트에 mass ulw를 붙이면 에이전트가 run 정의를 대신 작성해 주기도 하는데요. 이 글에서는 제가 직접 작성해 보았습니다.
조건·반복과 상태 전달은 run 바깥의 eval 셀에서
run 정의에는 조건이나 반복이 포함되지 않으며, run을 시작할 때는 미리 정할 수 있는 노드만 넣을 수 있습니다. "검증이 끝나면 확인된 문제만 고쳐라"나 "테스트가 실패하면 코드를 다시 고쳐라" 같은 판단은 run 바깥에서 처리해야 하는데요. 이 판단을 맡는 것이 바로 OmO 세션의 eval 셀입니다. eval 셀은 세션의 커널에서 JavaScript나 Python 코드를 실행하는 단위입니다. 셀 코드는 run을 시작하고 끝나기를 기다린 다음, 노드가 남긴 출력 파일을 읽어 다음 run의 노드 목록을 만듭니다.
이 글의 PR 리뷰 그래프에서는 리뷰 run, 검증 run, 수정·테스트 run 세 개를 만들고, 셀이 그 사이를 이어 주는 셈이죠. 검증 노드가 몇 개가 될지는 리뷰 run이 끝나야 알 수 있으므로, 셀이 발견 사항 수만큼 노드를 만들어 검증 run을 시작하는 방식으로 동작합니다. 같은 run 안에서는 서로 의존하지 않는 노드끼리 기다리지 않지만, 이 글의 그래프처럼 다음 run의 노드를 앞 run의 결과로 정해야 하면 앞 run이 끝나야 다음 run을 시작할 수 있습니다.
끊겨도 이어 가는 run과 노드 단위 재실행
OmO는 run의 진행 상황을 저널로 기록해 두므로, 세션이 중간에 끊겨도 다시 시작하면 이미 완료한 노드의 결과를 재사용하며 run을 이어서 실행합니다. 셀에서 다음 함수를 호출하면 실행 중이거나 끝난 run에서도 노드 하나만 골라 다시 실행하거나 고칠 수 있습니다.
retry(): run이 끝난 뒤, 실패하거나 취소된 노드와 그 때문에 실행되지 못한 뒤 노드를 다시 실행합니다.send(): 실행 중인 노드에 메시지를 보내 방향을 바로잡거나, 작업을 마쳤지만 아직 남아 있는 노드를 이전 맥락 그대로 되살려 작업을 이어 가게 합니다.amend(): 고친 run 정의를 같은 run에 다시 제출합니다. 노드마다 지문을 비교해서 바뀌거나 추가된 노드와 그에 의존하는 노드만 다시 실행하고, 나머지는 저장된 결과를 그대로 가져다 씁니다.
실행 기록은 파일로 남는데요. 여기에는 노드별 출력과 상태 전이 이벤트가 기록됩니다.
분기와 반복을 스크립트에 두는 Claude Code, 셀에 두는 OmO
똑같은 PR 리뷰 그래프를 Claude Code와 OmO로 각각 그려 나란히 비교해 보면 다음과 같습니다.
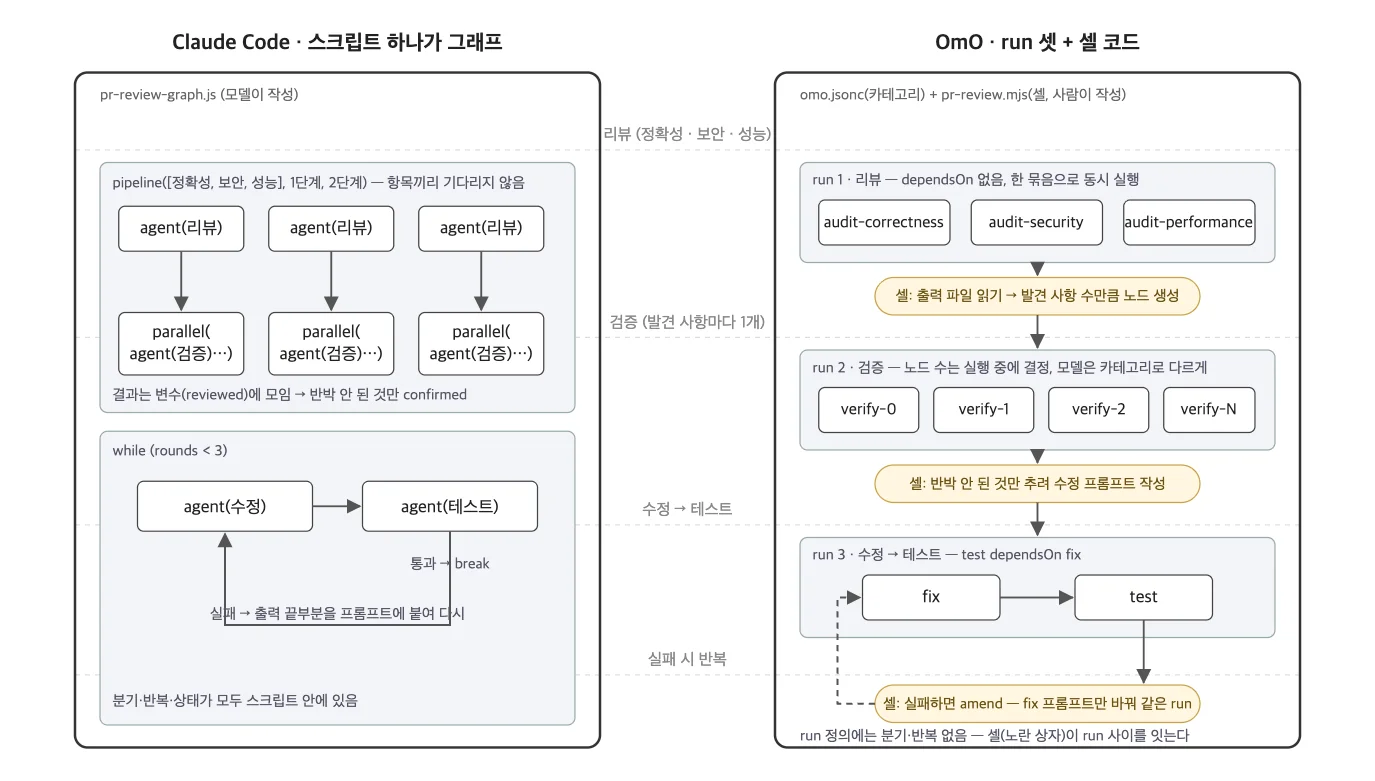
그림을 보면 Claude Code에서는 분기와 반복 처리가 모두 스크립트 안에 들어 있습니다. 반면 OmO에서는 분기와 반복이 run 정의 바깥에 있는 셀에 놓여 있죠. 작업 흐름도 다릅니다. Claude Code에서는 스크립트 하나가 처음부터 끝까지 쭉 이어지는데요. 이 글의 OmO 구현에서는 발견 사항마다 검증 노드를 만들기 위해 단계마다 run을 나누고, 셀이 다음 run을 새로 만들었습니다. 이 두 가지 구조 차이 때문에 설계 항목마다 두 도구의 장단점이 다르게 나타납니다.
설계 항목마다 Claude Code와 OmO는 어떤 장단점이 있을까요?
앞에서 정한 6가지 설계 항목을 기준으로 두 도구를 비교하면 다음과 같습니다.
| 설계 항목 | Claude Code 동적 워크플로 | OmO 워크플로 DAG | 유리한 쪽 |
|---|---|---|---|
| 병렬 실행 | pipeline()으로 먼저 끝난 리뷰부터 바로 검증함 | 같은 run 안에서는 의존 노드가 끝나는 대로 시작하지만, run 경계에서는 모두 기다림 | Claude Code |
| 상태 전달 | 스크립트 변수로 넘김. 노드 답을 JSON 형식으로 강제할 수 있음 | 노드 출력을 파일로 남김. 같은 run에서는 뒤 노드가 직접 읽고, run을 넘을 때는 셀이 읽어 다음 run에 넣어야 함 | Claude Code |
| 기각 권한 | 전용 기능 없음. 검증 노드와 스크립트 코드로 걸러 냄 | 같음. 검증 노드와 셀 코드로 걸러 냄 | 비슷함 |
| 실패 처리 | parallel()·pipeline() 안의 실패는 결과가 null로 남아 스크립트가 다시 부를 수 있음. 멈춘 실행을 다시 시작하면 실패한 노드와 그보다 늦게 시작한 노드를 완료됐어도 모두 다시 실행함(시작 순서 기준) | run이 끝난 뒤 retry()는 실패하거나 취소된 노드와 그 때문에 건너뛴 노드만, amend()는 바뀐 노드와 그 의존 노드만 다시 실행함(의존 관계 기준) | 실행 중 재시도는 Claude Code, 멈춘 뒤 재실행은 OmO |
| 비용·반복 제한 | 실행당 에이전트 1,000개 상한. 반복 횟수는 스크립트의 while로 제한함 | run당 노드 기본 64개(설정으로 변경 가능). 반복 횟수는 셀 코드의 while로 제한함 | 비슷함 |
| 종료 조건 | 스크립트가 끝나면 끝남. 전체 종료는 스크립트의 조건문이 판단함 | run은 노드가 모두 끝나면 끝남. 전체 종료는 셀 코드가 판단함 | 비슷함 |
설계 항목 외에도 두 도구는 다음 세 가지가 다릅니다.
| 항목 | Claude Code 동적 워크플로 | OmO 워크플로 DAG | 유리한 쪽 |
|---|---|---|---|
| 그래프 작성 | 워크플로로 처리해 달라고 하면 Claude가 스크립트를 작성함. 단계 목록은 승인 창과 /workflows에서 보이지만, 분기·반복까지 보려면 스크립트를 읽어야 함 | mass ulw로 에이전트에게 맡길 수도 있지만, 이 글에서는 직접 작성함. 노드와 의존 관계가 정의에 그대로 드러남 | 비슷함 |
| 모델 | 에이전트마다 Claude 모델 중에서 고를 수 있음 | 노드마다 다른 회사 모델을 지정할 수 있음 | OmO |
| 실행 중 개입 | 실행 중인 노드에 지시를 보낼 수 없음. 일시 정지·중지·재시작만 가능 | send()로 실행 중인 노드에 지시를 보낼 수 있음 | OmO |
두 도구의 차이가 뚜렷한 항목을 짚어 보면 다음과 같습니다.
- 병렬 실행은 Claude Code가 편한데요.
pipeline()덕분에 먼저 끝난 리뷰부터 바로 검증을 시작하죠. - 상태 전달 역시 Claude Code가 단순합니다. 변수로 넘기면 그만이고 JSON 형식으로 맞추도록 강제할 수도 있죠. 반면 OmO는 노드 출력이 파일로 남기 때문에 run을 넘을 때는 셀이 그 파일을 직접 읽어서 다음 run에 넣어야 하는데요. 발견 사항마다 검증 노드를 하나씩 만드는 작업은 두 도구 모두 할 수 있지만, Claude Code는 스크립트 안에서 바로 만들고 OmO는 리뷰 run이 끝난 뒤 셀이 새 run을 만들거나 끝난 run에
amend()로 노드를 더해야 합니다. - 멈춘 뒤 재실행과 실행 중 개입은 OmO가 유리합니다. 문제가 생기면 run이 끝난 뒤
retry()나amend()로 해당 노드와 그 노드에 의존하는 노드만 다시 돌릴 수 있고,send()로 실행 중인 노드에 지시를 보낼 수도 있죠. 반면 Claude Code는 멈춘 실행을 다시 시작할 때 실패한 노드와 그보다 늦게 시작한 노드를 모두 다시 돌려야 하는 데다, 실행 중인 노드에 지시를 보낼 수 없습니다. 다만 실행 중에 실패한 노드를 다시 부르는 일은 Claude Code가 유리합니다.parallel()이나pipeline()안에서 실패한 노드는 결과 자리가 null로 남아 스크립트가 그 노드만 다시 부르도록 짤 수 있지만, OmO는 run이 끝나야retry()나amend()로 다시 돌릴 수 있기 때문이죠. - 다른 회사 모델을 섞어 쓰는 것은 기본 기능으로는 OmO만 할 수 있는데요. 검증 노드에 리뷰 노드와 아예 다른 회사 모델을 붙일 수 있습니다. 덕분에 같은 모델끼리 서로 결과물을 확인하는 일을 피할 수 있죠.
정리하면 Claude Code는 스크립트 하나로 빠르게 돌려 보는 작업에 어울리고, OmO는 단계를 하나하나 통제하고 고쳐 가며 돌리는 작업에 알맞습니다. 그럼 이 장단점이 실제 실행 과정에서도 그대로 나타나는지 직접 확인해 보겠습니다.
같은 PR을 두 도구로 리뷰하면 결과가 어떻게 다를까요?
도입부에서 PR 리뷰와 수정을 에이전트 하나에 모두 맡기면 세 가지 문제가 생길 수 있다고 했는데요. 특정 단계를 빠뜨리지 않도록 강제하기 어렵고, 문제를 놓치거나 문제가 아닌 것을 문제로 잘못 넘길 수 있으며, 어디서 판단이 어긋났는지 추적하기 어렵다는 점이었습니다. 같은 PR을 Claude Code와 OmO로 각각 리뷰해 그래프가 세 가지 문제에 실제로 어떻게 작동하는지 살펴보고, 설계 항목별로 비교한 두 도구의 차이가 실행에서도 나타나는지 확인했습니다.
문제 4개와 함정 1개를 넣은 실습용 PR과 실행 조건
주문 금액을 계산하는 작은 Python 프로젝트에 쿠폰 할인 기능을 추가하는 PR을 준비했습니다. 모듈 docstring에는 "할인율은 상품 소계에만 적용한다", "쿠폰은 만료일 당일까지 유효하다" 같은 규칙을 적어 두었는데요. 여기에 실제 문제 4개와 문제처럼 보이지만 안전한 코드인 함정 1개를 일부러 넣었습니다.
| ID | 구분 | 유형 | 내용 | 기존 테스트로 발견 |
|---|---|---|---|---|
| B1 | 문제 | 정확성 | 만료일 당일 쿠폰이 무효 처리됨(<를 써야 할 곳에 <=를 씀) | O(테스트 1개 실패) |
| B2 | 문제 | 정확성 | 배송비가 포함된 총액에 할인율을 적용 | X |
| B3 | 문제 | 보안 | 쿠폰 코드를 문자열로 이어 붙여 SQL에 넣음(SQL 인젝션) | X |
| B4 | 문제 | 성능 | 주문 항목마다 상품을 따로 조회(N+1 쿼리) | X |
| D1 | 함정 | - | 정렬 기준을 문자열로 이어 붙이지만 허용 목록을 거쳐서 안전한 코드 | - |
이 PR 상태로 테스트를 돌리면 테스트 10개 중 1개만 실패해 B1(만료일 경계)만 드러납니다. 나머지 문제 3개(B2~B4)는 테스트로 드러나지 않아서 리뷰 그래프가 직접 찾아내야 하죠. B4의 N+1 쿼리는 목록을 한 번 조회한 뒤 항목 수(N)만큼 쿼리를 더 보내는 문제입니다. 함정은 리뷰 에이전트가 안전한 코드를 문제로 착각하는지 확인하려고 넣었습니다.
두 도구 모두 도입부에서 소개한 PR 리뷰 그래프를, 각 도구의 구조로 표현해 본 방식 그대로 구현했습니다.
- 리뷰 에이전트 셋이 각각 정확성·보안·성능 측면에서 코드를 살핍니다.
- 리뷰 에이전트가 문제를 보고하면, 검증 에이전트가 보고된 문제를 반박해 봅니다.
- 검증에서 유지된 문제만 수정 에이전트 하나가 고칩니다.
- 가장 작은 언어 모델을 쓰는 에이전트가 테스트 명령을 실행하고, 테스트가 실패하면 수정과 테스트를 반복합니다.
두 도구의 실행 조건은 다음과 같습니다.
| 조건 | Claude Code | OmO |
|---|---|---|
| 검증 모델 | 리뷰 에이전트와 다른 Claude 모델 | 리뷰 에이전트와 다른 회사의 모델 |
| 실행 방식 | 비대화형 모드(claude -p) | 비대화형 모드(omo -p) |
| 셸 명령 권한 | 테스트 실행 명령만 허용(리뷰·검증 에이전트) | 파일 수정 도구는 끄고 셸 명령은 켜 둠(검증 노드) |
| 검증 기준 | 세 항목 모두 "재현되거나 명시된 규칙을 위반한다는 확신이 없으면 기각" | 정확성·보안은 같음. 성능만 "코드 패턴으로 판단" |
OmO의 성능 검증 기준은 먼저 실행한 Claude Code의 결과를 보고 바꾼 것으로, 그 이유는 아래 실행 결과에서 설명하겠습니다. 에이전트가 미리 정답을 알지 못하도록 어떤 문제를 넣었는지 적은 목록은 저장소 밖에 두었습니다. 작업이 끝난 뒤에는 테스트를 직접 다시 돌리고, 저장소에서 바뀐 파일을 확인했습니다. 아래 결과는 이 조건에서 실행한 것으로, 모델 응답에 따라 달라질 수 있습니다.
문제 4개를 모두 찾았지만 B4(N+1 쿼리) 판정이 갈린 실행 결과
같은 PR을 두 도구로 리뷰한 결과를 실행 과정과 문제별 판정으로 나눠 살펴보겠습니다.
실행 과정 비교
| 구간 | Claude Code | OmO |
|---|---|---|
| 검증이 시작되는 시점 | 리뷰가 끝나는 항목부터 바로 | 리뷰 3개가 모두 끝난 뒤 |
| 복구를 위해 다시 실행한 노드 | 없음 | 검증 노드 하나만 두 번 다시 실행, 이어서 수정·테스트만 다시 실행 |
| 노드 실행 횟수 | 11회 | 13회 |
| 토큰 | 약 27만 | 약 19만 |
두 실행은 사용한 모델이 달라 같은 글도 토큰 수가 다르게 집계돼 토큰은 직접 비교하기 어렵습니다.
문제별 판정
| ID | Claude Code | OmO |
|---|---|---|
| B1 만료일 경계 | 발견 → 유지 → 수정 | 발견 → 유지 → 수정 |
| B2 배송비 할인 | 발견 → 유지 → 수정 | 발견 → 유지 → 수정 |
| B3 SQL 인젝션 | 발견 → 유지 → 수정 | 발견 → 유지(검증 노드 재실행 뒤) → 수정 |
| B4 N+1 쿼리(성능 검증 기준 다름) | 발견 → 기각 → 미수정 | 발견 → 유지 → 수정 |
| D1 함정(정상 코드) | 문제로 보고하지 않음 | 문제로 보고하지 않음 |
차이가 없었던 문제 발견 단계
리뷰 단계에서는 두 실행 모두 일부러 넣어 둔 문제 4개를 전부 찾았고, 함정으로 넣어 둔 정상 코드는 문제로 보고하지 않았습니다.
실행 과정에서 확인한 두 가지
설계 항목별로 비교한 내용 가운데 두 가지를 실행에서 확인했습니다.
- 검증을 시작하는 시점: Claude Code는 성능 리뷰가 끝나자마자 성능 문제 검증을 시작했지만, OmO는 리뷰 run 전체가 끝날 때까지 기다렸습니다.
- 다시 실행하는 범위: OmO는 판정을 제대로 돌려주지 않은 검증 노드 하나만 두 번 고쳐 돌렸고, 나머지 검증 노드 셋은 다시 돌리지 않았습니다. Claude Code는 이번 실습에서 복구할 일이 없어 재실행 범위는 비교할 수 없었습니다.
엄격한 검증 기준 때문에 Claude Code에서 기각된 B4(N+1 쿼리)
Claude Code의 검증 에이전트는 코드에 N+1 쿼리 패턴이 있다는 사실을 인정하면서도 B4 보고를 기각했습니다.
The code does contain the pattern the reviewer describes. … But this is not a demonstrable performance problem, and it violates no stated rule. shop/db.py shows the connection is in-process sqlite3 (default ":memory:”). A per-row SELECT there costs microseconds …
(번역) 코드에 리뷰 에이전트가 말한 패턴이 있는 것은 맞습니다. … 하지만 입증할 수 있는 성능 문제는 아니고, 명시된 규칙을 위반하지도 않습니다. shop/db.py를 보면 연결은 프로세스 안에서 도는 sqlite3(기본값 ":memory:”)입니다. 여기서는 행마다 SELECT를 보내도 몇 마이크로초밖에 걸리지 않습니다 …
검증 에이전트는 검증 기준인 "재현되거나 명시된 규칙을 위반한다는 확신이 없으면 기각"을 그대로 따랐습니다. docstring에 쿼리 횟수 규칙이 없고 메모리 SQLite에서는 눈에 띄게 느려지지 않으니 기준대로라면 B4 보고를 기각하는 게 맞죠. 실제로 SQLite는 애플리케이션과 같은 프로세스에서 돌아 쿼리마다 네트워크 왕복이 없어 이 환경만 놓고 보면 검증 에이전트의 판단에도 근거가 있었습니다. N+1 쿼리는 DB가 네트워크 너머에 있는 클라이언트-서버 구성에서 문제가 되는데요. 결국 거짓긍정(문제가 아닌 것을 문제로 판정하는 일)을 줄이려고 세운 엄격한 기준이 일부러 넣어 둔 문제까지 걸러 낸 셈입니다.
그래서 OmO 구현에서는 성능 문제를 검증할 때만 “코드 패턴으로 판단"이라는 기준을 따로 주었는데요. 그 결과 OmO의 검증 에이전트는 같은 B4 보고를 유지로 판정했습니다. 도구보다는 검증 기준의 차이가 컸던 것으로 보입니다. 다만 두 실행은 검증 모델과 셸 명령 권한도 달랐습니다.
테스트는 모두 통과했지만 고친 문제 수가 달랐던 최종 결과
OmO는 일부러 넣어 둔 문제 4개(B1~B4)를 모두 고쳤고, Claude Code는 B4를 뺀 3개를 고쳤습니다. 다만 OmO에서는 B3(SQL 인젝션)를 검증한 에이전트가 처음에 판정을 JSON으로 돌려주지 않아 B3 검증 노드만 amend()로 두 번 고쳐 돌린 뒤에야 유지 판정이 나왔습니다. 두 도구 모두 수정 뒤 기존 테스트 10개를 통과했습니다. 테스트 코드가 있는 tests/ 디렉터리의 파일은 바뀌지 않았으니, 테스트를 고쳐서 통과시킨 것은 아니었습니다.
정리하면 이번 실습에서 두 도구의 차이는 무엇을 찾느냐가 아니라 언제 검증을 시작하느냐에서 나타났고, OmO에서는 문제가 생긴 노드와 그 노드에 의존하는 노드만 다시 돌릴 수 있다는 점도 확인했습니다.
그래프보다 그래프를 감싼 코드와 권한 설정에서 드러난 문제 3가지
결과만 보면 두 도구 모두 성공에 가깝습니다. 일부러 넣어 둔 문제 4개를 모두 찾았고, 수정 뒤 테스트도 통과했으니까요. 하지만 실행 기록을 다시 살펴보니, 그래프 구조가 아니라 그래프를 감싼 코드와 노드의 권한 설정에서 문제 3가지가 드러났습니다.
1. 판정이 없는 결과를 기각으로 처리한 실수
OmO에서는 검증 에이전트가 판정을 돌려주지 않은 경우를 기각과 구분하지 않아 실제 문제를 수정 단계로 넘기지 못했습니다. 검증 에이전트는 '반박 여부'와 '이유'를 JSON 형식으로 반환해야 하지만, 항상 규칙을 따르지는 않는데요.
- OmO의 경우: B3(SQL 인젝션)를 검증한 에이전트가 판정을 JSON으로 돌려주지 않고 다른 말만 남긴 채 작업을 마쳤습니다. 제가 작성한 셀 코드는 JSON을 읽지 못하면 무조건 기각으로 처리하도록 짜여 있어 B3는 수정 에이전트로 넘어가지 않았습니다. SQL 인젝션을 확인하는 테스트가 없어 테스트는 통과했고, 테스트 결과만으로는 B3가 빠진 것을 알 수 없었습니다.
- Claude Code의 경우: 출력 스키마로 JSON 형식을 강제했습니다. 형식이 어긋나면 런타임이 다시 답하게 하고, 다섯 번 시도한 뒤에도 실패하면 오류를 냅니다. 이번 실행에서는 판정이 빠진 검증 결과가 없었습니다. 다만
pipeline()안에서 중지되거나 실패한 에이전트의 결과는 null로 남기에 스크립트도 null을 기각과 구분해 처리해야 합니다. - 개선 방향: 판정이 없는 결과는 기각과 구분되는 별개의 상태로 다뤄야 합니다. OmO에는 판정이 없는 검증 노드만 고쳐 다시 돌릴 수 있는
amend()가 이미 있었습니다. 1라운드(처음 실행)의 셀 코드에 판정이 없는 노드를amend()로 다시 돌리는 분기를 넣었다면, B3 검증 노드를 고쳐 다시 돌리는 2라운드까지 갈 필요가 없었을 것입니다.
2. OmO에서는 너무 느슨하고 Claude Code에서는 너무 엄격했던 셸 명령 권한
OmO에서는 만들지 말라고 한 파일이 생겼고, Claude Code에서는 문제를 재현하는 실행까지 막혔습니다.
- OmO의 경우: 실행을 마친 뒤 저장소를 확인해 보니
run_test.py라는 파일이 남아 있었습니다. 검증 에이전트 중 하나가 B2(배송비 할인) 문제를 재현하려고 셸 리다이렉션으로 만든 파일이었습니다. 해당 노드는 파일 수정 도구를 꺼두고 프롬프트에도 파일을 만들지 말라고 명시했지만, 셸 명령을 쓸 수 있어서 생긴 일입니다. - Claude Code의 경우: 셸 명령 가운데 테스트 실행 명령만 허용 규칙에 넣어 둔 탓에, 리뷰 에이전트와 검증 에이전트가 문제를 재현하려고 짠 짧은 Python 스크립트가 27번 중 16번 거부됐습니다. 실행이 거부된 경우, 에이전트는 문제가 실제로 재현되는지 확인하지 못하고 코드를 읽고 짐작할 수밖에 없었습니다.
- 개선 방향: 이번 실습의 OmO처럼 도구를 켜고 끄거나, Claude Code처럼 허용할 셸 명령을 고르는 방식만으로는 파일 접근 범위를 통제하기 어렵습니다. 셸 명령을 열어 두면 셸로도 파일을 만들 수 있고, 셸 명령을 좁히면 문제를 재현하는 실행까지 막히기 때문입니다. 셸 명령에도 적용되는 경로 단위 쓰기 제한(예: 샌드박스의 쓰기 금지 경로 설정)을 두거나, 노드마다 워크트리(같은 저장소에 연결된 별도 작업 디렉터리)를 따로 두거나, 작업이 끝난 뒤 변경된 파일을 검사하는 장치 중 하나는 마련해야 합니다.
3. 같은 문제를 두 번 넘기고 테스트 결과를 잘못 읽은 오케스트레이션 코드
노드 사이에서 결과를 넘기고 읽는 코드에 실수가 있어 같은 문제를 수정 노드로 두 번 보내고 통과한 테스트를 실패로 기록했습니다. 두 구현 방식 모두 리뷰 에이전트가 발견한 문제를 검증 노드로 보내고, 검증에서 유지된 문제를 다시 수정 노드로 넘기는 역할은 오케스트레이션 코드가 맡았는데요. Claude Code에서는 Claude가 작성한 스크립트가, OmO에서는 제가 작성한 셀 코드가 오케스트레이션 코드입니다. 오케스트레이션 코드가 잘못 짜여 있으면 그래프 구조가 완벽해도 엉뚱한 결과가 나옵니다.
- Claude Code의 경우: B3(SQL 인젝션)가 정확성 리뷰와 보안 리뷰에서 각각 보고되는 바람에 수정 노드로 두 번이나 넘어갔습니다. 두 리뷰 에이전트가 같은 문제를 보고했을 때 하나로 합치는 처리가 Claude가 작성한 스크립트에 없었던 탓이죠.
- OmO의 경우: 제가 작성한 셀 코드가 테스트 실행 결과의 출력 형식을 잘못 읽었습니다. 그 결과 실제로는 통과한 테스트를 1라운드 요약에 실패로 잘못 기록했습니다.
- 개선 방향: 테스트 결과처럼 그래프 밖에서 증거를 가져와 판단하는 방식 자체는 맞지만, 그 증거를 읽어 내는 코드 역시 꼼꼼히 검증해야 합니다. 같은 문제를 하나로 합치는 처리도 오케스트레이션 코드에 넣어야 합니다.
실습 결과로 본 그래프의 역할
같은 PR을 에이전트 하나로 처리해 비교하지는 않았기 때문에 그래프로 얼마나 나아졌는지 수치로 보여 주기는 어렵습니다. 다만 도입부에서 그래프에 기대한 역할은 실행에서 확인할 수 있었는데요.
- 단계 강제: 다음 단계를 정한 것은 에이전트가 아니라 미리 설계한 그래프였습니다. 리뷰 에이전트가 보고한 문제는 모두 검증 에이전트를 거쳤고, 검증 단계를 건너뛴 경우는 없었습니다. 검증에서 유지된 문제만 수정 단계로 넘어갔고, Claude Code에서 기각된 B4(N+1 쿼리)는 끝까지 고쳐지지 않았습니다. 검증 에이전트가 일부러 넣어 둔 문제를 기각했지만, 단계는 원래 그래프대로 강제된 셈이죠.
- 문제 누락과 자기 검증: 정확성·보안·성능을 리뷰 에이전트 셋이 하나씩 맡아 두 도구 모두 일부러 넣어 둔 문제 4개를 모두 찾았습니다. 검증은 리뷰와 다른 모델을 쓴 검증 에이전트가 따로 맡았는데요. 이번 실습에서는 리뷰 에이전트가 함정(D1)을 처음부터 문제로 보고하지 않아 검증 에이전트가 문제가 아닌 것을 걸러 내는 상황은 없었습니다. 대신 Claude Code의 검증 에이전트가 리뷰 결과를 뒤집은 사례(B4)가 있었고, 이때는 엄격한 기준 때문에 일부러 넣어 둔 문제를 걸러 냈습니다. 검증을 다른 에이전트에 맡기면 판정은 실제로 달라질 수 있지만, 판정의 질이 검증 기준의 영향을 크게 받는다는 점이 드러났습니다.
- 추적: 에이전트마다 받은 지시와 출력 결과, 판정이 따로 남은 덕분에 어느 노드가 왜 그렇게 판정했는지, 어느 노드가 판정 형식을 어겼는지, 어느 에이전트가 파일을 만들었는지까지 추적할 수 있었습니다. 그래프를 감싼 코드와 권한 설정에서 드러난 문제 3가지의 원인을 짚어 낸 것도 에이전트별 기록 덕분입니다.
맺음말
지금까지 그래프 엔지니어링의 개념을 정리하고, Claude Code와 OmO의 그래프 구조와 설계 항목별 장단점을 비교한 뒤, 같은 PR로 두 도구를 실행해 봤습니다. 핵심을 정리하면 다음과 같습니다.
- 그래프 엔지니어링은 루프를 품는 설계 방법입니다. 여러 단계 작업을 에이전트 여럿에게 나눠 맡기고 그 사이 규칙을 미리 그래프로 정해 두는데요. 실습 그래프의 수정-테스트 구간도
/goal과 같은 루프였죠. - 그래프는 기대한 역할을 대체로 해냈습니다. 검증을 건너뛴 경우가 없었고, 에이전트별 기록으로 문제의 원인을 짚을 수 있었습니다. 다만 판정의 질은 검증 기준의 영향을 크게 받았고요.
- 두 도구는 조건·반복을 두는 위치가 다릅니다. 실습에서는 검증을 시작하는 시점과 다시 실행하는 범위를 확인했죠. Claude Code는 먼저 끝난 리뷰부터 바로 검증했고, OmO는 문제가 생긴 노드와 그 의존 노드만 다시 돌렸습니다. 그래서 스크립트 하나로 빠르게 돌려 보려면 Claude Code가, 단계를 통제하며 고쳐 가려면 OmO가 어울립니다.
- 결과를 가른 것은 그래프 구조가 아니었습니다. 두 도구 모두 문제 4개를 찾았지만, Claude Code는 검증 기준 때문에 B4(N+1 쿼리)를, OmO는 처음 실행에서 판정 처리 코드 때문에 B3(SQL 인젝션)를 수정 단계로 넘기지 못했죠. 검증 노드에 줄 기준, 노드 출력을 읽고 넘기는 코드, 노드의 셸 명령 권한을 정하고 확인하는 일은 어떤 도구를 쓰든 사람의 몫입니다. Claude Code처럼 코드를 에이전트가 쓰더라도 마찬가지고요.
이번 실습은 작은 저장소에서 도구마다 한 번씩 돌린 결과라 한계가 있긴 합니다. 두 도구의 실행 조건이 완전히 같지 않았고, 에이전트 하나로 처리한 결과와 비교하지도 않았으며, 에이전트의 판단은 매번 달라질 수 있으니까요. 그래도 그래프를 그리기 전에 검증 노드에 어떤 기준을 줄지, 노드 출력을 어떻게 읽고 넘길지, 노드에 셸 명령 권한을 어디까지 줄지부터 정해야 한다는 점은 도구와 상관없이 유효할 것으로 보입니다.
60줄 남짓한 PR에도 노드를 11~13회 돌렸을 만큼 그래프는 비용이 적지 않은데요. 그래서 그래프를 처음 도입한다면 다음 순서로 작게 시작하길 권합니다.
- 반복할 작업, 확인 가능한 검증 장치, 명확한 종료 조건을 갖춘 루프 하나로 시작합니다.
- 운영하면서 실패하는 유형을 파악합니다.
- 필요할 때마다 리뷰 단계, 병렬 실행, 검증 단계를 하나씩 더합니다.
그러다 보면 어느새 하나의 그래프가 완성되어 있을 겁니다.
그래프 엔지니어링의 개념을 정리하며 인용한 Steinberger의 질문으로 돌아가 보겠습니다. 루프에서 그래프로 넘어갔느냐고 물었는데요. 이번 실습에서 본 답은 '넘어갔다'보다 '루프가 그래프 안으로 들어갔다'에 가깝습니다. 인포그랩 AI DevOps 엔지니어 Harvey가 「루프 엔지니어링 실전: Claude Code /goal 분석과 Stop 훅 재구현」에서 강조한 완료 조건은 노드마다 똑같이 필요했죠. 노드에 어떤 기준과 증거를 줄지 정하는 일도 루프 하나를 만들 때만큼 중요했고요. 특히 검증 노드가 리뷰 노드의 판단을 그대로 따르지도, 지나치게 걸러 내지도 않게 기준을 세우는 방법은 따로 다뤄 볼 만한 주제인데요. 기회가 되면 다음 글에서 이어 가 보겠습니다.
에이전트에 코드 리뷰를 맡기기 전에 무엇을 버그로 볼지부터 정하세요
에이전트를 여럿 엮을 때는 그래프 모양보다 검증 노드에 줄 기준, 노드 출력을 읽고 넘기는 방식, 노드별 권한을 먼저 정하는 일이 중요합니다. 인포그랩은 업무 복잡도에 맞춰 단일 에이전트와 멀티 에이전트 중 알맞은 구조를 정하고, 단계마다 맞는 모델과 도구를 배치하며, 사람이 최종 승인할 지점까지 함께 설계합니다.
참고 자료
- “Graph Engineering vs Loop Engineering: What Actually Changed”, Louis-François Bouchard, https://www.louisbouchard.ai/graph-engineering-explained/
- “3 Years of Graph Engineering with LangGraph”, LangChain, https://www.langchain.com/blog/3-years-of-graph-engineering-with-langgraph
- “Are we still talking loops or did we shift to graphs yet?”, Peter Steinberger(X), https://x.com/steipete/status/2078277297791189132
- “Loop Engineering Is Dead. Enter Graph Engineering”, Hamel Husain(X), https://x.com/HamelHusain/status/2078346425621237935
- “Graph 엔지니어링 vs Loop 엔지니어링: 실제로 달라진 것은 무엇인가”, GeekNews, https://news.hada.io/topic?id=32544
- “Building effective agents”, Anthropic, https://www.anthropic.com/engineering/building-effective-agents
- “Multi-Agents: What's Actually Working”, Cognition, https://cognition.com/blog/multi-agents-working
- “Introducing dynamic workflows in Claude Code”, Claude, https://claude.com/blog/introducing-dynamic-workflows-in-claude-code
- “Orchestrate subagents at scale with dynamic workflows”, Claude Code Docs, https://code.claude.com/docs/en/workflows
- “oh-my-openagent”, GitHub, https://github.com/code-yeongyu/oh-my-openagent
- “Release v5.0.0-beta.8”, oh-my-openagent(GitHub), https://github.com/code-yeongyu/oh-my-openagent/releases/tag/v5.0.0-beta.8
- “mass-ulw
SKILL.md”, oh-my-openagent(GitHub), https://github.com/code-yeongyu/oh-my-openagent/blob/dev/packages/omo-senpi/skills/mass-ulw/SKILL.md - “dag-library
SKILL.md”, oh-my-openagent(GitHub), https://github.com/code-yeongyu/oh-my-openagent/blob/dev/packages/omo-senpi/skills/dag-library/SKILL.md - “Configuration Reference”, oh-my-openagent(GitHub), https://github.com/code-yeongyu/oh-my-openagent/blob/dev/docs/reference/configuration.md
- “Many Small Queries Are Efficient In SQLite”, SQLite, https://www.sqlite.org/np1queryprob.html
- “Configure the sandboxed Bash tool”, Claude Code Docs, https://code.claude.com/docs/en/sandboxing
- “루프 엔지니어링 실전: Claude Code /goal 분석과 Stop 훅 재구현”, 인포그랩, https://insight.infograb.net/blog/2026/09/23/loop-engineering/

Jhin
Software Engineer
Software Engineer로서, AI 전환을 위한 시스템과 운영 구조를 설계·구축합니다. 업무와 서비스에 AI를 실제로 적용할 수 있도록 자동화 흐름과 실행 환경을 만들고, 개발부터 운영까지 전 과정을 함께 다룹니다. 반복되는 문제를 구조적으로 개선하고, 더 효율적으로 일할 수 있는 환경을 만드는 데 관심이 많습니다.
이 저자의 글 모두 보기 →이 글이 도움이 되셨나요?
인포그랩 전문가가 맞춤 상담을 도와드립니다.
관련 글
루프 엔지니어링 실전: Claude Code /goal 분석과 Stop 훅 재구현
테스트는 실패하는데 코딩 에이전트가 '완료했다'며 멈춘 적이 있나요? 에이전트가 완료를 스스로 판단하기 때문입니다. 이 판정을 시스템에 맡기는 루프 엔지니어링을 살펴보고, Claude Code /goal을 분석해 Stop 훅으로 재구현해 봤습니다.
AI 에이전트 스킬이 발동하지 않는 이유: SKILL.md 결함과 개선법
AI 에이전트가 스킬을 고르지 않거나 엉뚱한 절차를 밟는다면 SKILL.md를 살펴야 합니다. 실제 파일 238개를 분석한 연구가 찾아낸 결함 유형과 이를 개선하는 8가지 방법, 업무용 스킬 5개에 직접 적용한 결과를 정리했습니다.
에이전트 옵저버빌리티 - AI 에이전트의 '조용한 실패'를 잡는 법
이 글은 에이전트 옵저버빌리티의 개념과 동작 방식, APM·LLM 옵저버빌리티와의 차이, 구현 도구를 살펴봅니다. 아울러 Langfuse와 Google Gemini로 PR 리뷰 에이전트의 활동을 추적·평가하는 실습을 다룹니다. 또 에이전트 옵저버빌리티를 원활하게 운영하기 위해 유념할 사항도 알아봅니다.